2 - Produktionsumgebung
Erstellen Sie einen produktionsreifen Kubernetes-Cluster
Ein produktionsreifer Kubernetes-Cluster erfordert Planung und Vorbereitung.
Wenn Ihr Kubernetes-Cluster geschäftskritische Workloads ausführen soll, muss er so konfiguriert sein, dass er belastbar ist.
Diese Seite erläutert Schritte, die Sie unternehmen können, um einen produktionsreifen Cluster einzurichten
oder einen bestehenden Cluster für den Produktionseinsatz vorzubereiten.
Wenn Sie bereits mit der Produktionseinrichtung vertraut sind und nur die Links benötigen, fahren Sie mit Nächste Schritte fort.
Überlegungen zur Produktion
Typischerweise hat eine Kubernetes-Produktionsumgebung mehr Anforderungen als eine
Kubernetes-Umgebung für persönliches Lernen, Entwicklung oder Tests. Eine Produktionsumgebung kann
sicheren Zugriff durch viele Benutzer, konsistente Verfügbarkeit und die Ressourcen zur Anpassung
an sich ändernde Anforderungen erfordern.
Wenn Sie entscheiden, wo Ihre Kubernetes-Produktionsumgebung betrieben werden soll
(lokal oder in einer Cloud) und wie viel Verwaltung Sie selbst übernehmen
oder anderen überlassen möchten, berücksichtigen Sie, wie Ihre Anforderungen an einen Kubernetes-Cluster
durch die folgenden Aspekte beeinflusst werden:
Verfügbarkeit: Eine Einzel-Maschinen-Kubernetes-Lernumgebung hat einen einzelnen Ausfallpunkt. Die Erstellung eines hochverfügbaren Clusters bedeutet die Berücksichtigung von:
- Trennung der Steuerungsebene von den Worker-Knoten.
- Replikation der Steuerungsebenen-Komponenten auf mehreren Knoten.
- Lastverteilung des Datenverkehrs zum API-Server des Clusters.
- Ausreichend Worker-Knoten verfügbar oder bei Bedarf schnell verfügbar, wenn sich die Workloads ändern.
Skalierung: Wenn Sie erwarten, dass Ihre Kubernetes-Produktionsumgebung eine stabile Nachfrage
erhält, können Sie möglicherweise die benötigte Kapazität einrichten und sind fertig. Wenn Sie jedoch
erwarten, dass die Nachfrage im Laufe der Zeit wächst oder sich drastisch ändert, basierend auf
saisonalen Schwankungen oder besonderen Ereignissen, müssen Sie planen, wie Sie skalieren können, um den erhöhten
Druck durch mehr Anfragen an die Steuerungsebene und Worker-Knoten zu bewältigen oder herunterskalieren, um ungenutzte
Ressourcen zu reduzieren.
Sicherheit und Zugriffsverwaltung: Auf Ihrem eigenen
Kubernetes-Lerncluster haben Sie volle Administratorrechte. Bei gemeinsam genutzten Clustern mit wichtigen Workloads und
mehr als ein oder zwei Benutzern ist jedoch ein differenzierterer Ansatz erforderlich, wer und was
auf Cluster-Ressourcen zugreifen kann. Sie können rollenbasierte Zugriffskontrolle
(RBAC) und andere
Sicherheitsmechanismen verwenden, um sicherzustellen, dass Benutzer und Workloads Zugriff auf die
benötigten Ressourcen erhalten, während Workloads und der Cluster selbst sicher bleiben.
Sie können Grenzen für die Ressourcen setzen, auf die Benutzer und Workloads zugreifen können,
indem Sie Richtlinien und
Container-Ressourcen verwalten.
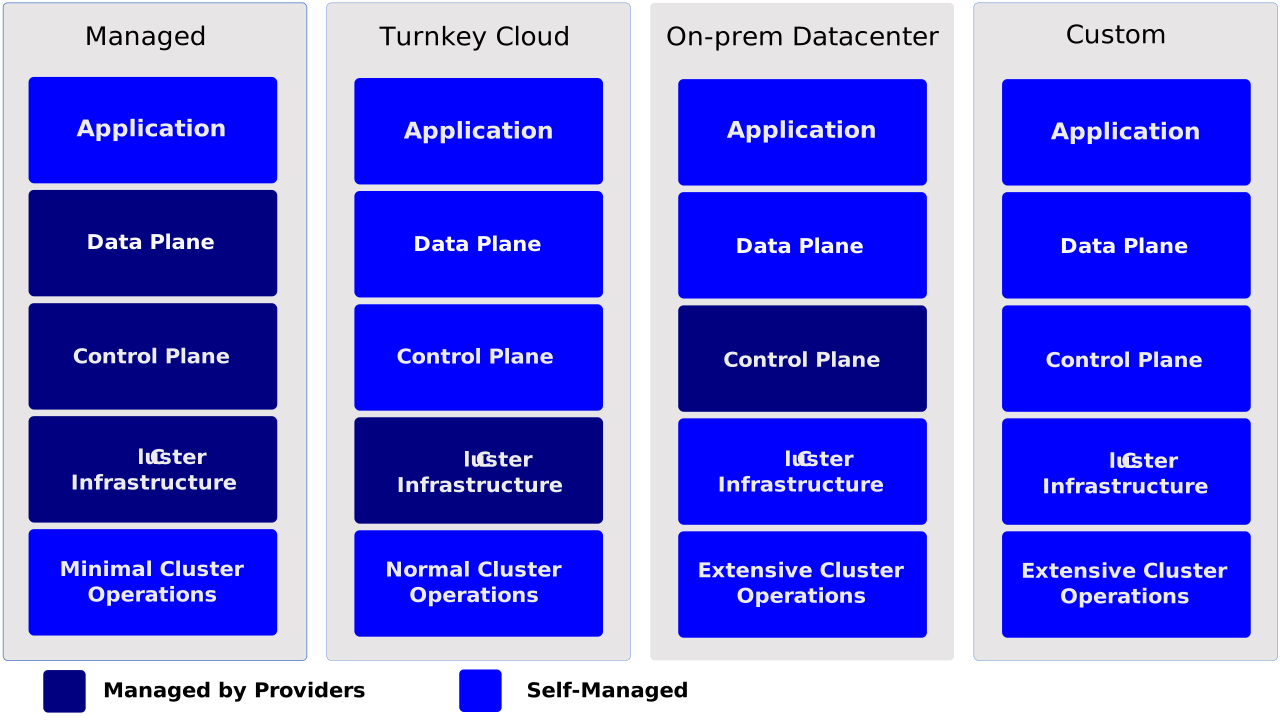
Bevor Sie eine Kubernetes-Produktionsumgebung selbst aufbauen, erwägen Sie,
einen Teil oder die gesamte Arbeit an Anbieter von
schlüsselfertigen Cloud-Lösungen
oder andere Kubernetes-Partner zu übergeben.
Optionen umfassen:
- Serverlos: Führen Sie Workloads einfach auf der Infrastruktur von Drittanbietern aus, ohne
einen Cluster selbst zu verwalten. Sie werden für Dinge wie CPU-Nutzung, Speicher und
Festplattenanfragen berechnet.
- Verwaltete Steuerungsebene: Lassen Sie den Anbieter die Skalierung und Verfügbarkeit
der Steuerungsebene des Clusters verwalten sowie Patches und Upgrades durchführen.
- Verwaltete Worker-Knoten: Konfigurieren Sie Knotenpools nach Ihren Bedürfnissen,
dann stellt der Anbieter sicher, dass diese Knoten verfügbar sind und bei Bedarf Upgrades implementiert werden.
- Integration: Es gibt Anbieter, die Kubernetes mit anderen
Diensten integrieren, die Sie möglicherweise benötigen, wie Speicher, Container-Registries, Authentifizierungsmethoden
und Entwicklungswerkzeuge.
Unabhängig davon, ob Sie einen Kubernetes-Produktionscluster selbst erstellen oder mit
Partnern zusammenarbeiten, lesen Sie die folgenden Abschnitte, um Ihre Anforderungen in Bezug
auf die Steuerungsebene, die Worker-Knoten, die Benutzerzugriffe und die
Workload-Ressourcen Ihres Clusters zu bewerten.
Einrichtung eines Produktionsclusters
In einem Kubernetes-Produktionscluster verwaltet die Steuerungsebene den Cluster
über Dienste, die auf viele verschiedene Arten über mehrere Computer verteilt werden können. Jeder
Worker-Knoten stellt jedoch eine einzelne Einheit dar, die für die Ausführung von Kubernetes-Pods konfiguriert ist.
Steuerungsebene in der Produktion
Der einfachste Kubernetes-Cluster hat die gesamte Steuerungsebene und die Worker-Knoten-Dienste
auf derselben Maschine. Sie können diese Umgebung erweitern, indem Sie Worker-Knoten hinzufügen,
wie im Diagramm in den
Kubernetes-Komponenten dargestellt.
Wenn der Cluster für eine kurze Zeit oder nach der Identifizierung eines schwerwiegenden Problems verworfen werden kann,
könnte dies Ihren Anforderungen genügen.
Wenn Sie jedoch einen dauerhafteren, hochverfügbaren Cluster benötigen, sollten Sie
Möglichkeiten in Betracht ziehen, die Steuerungsebene zu erweitern. Standardmäßig sollte der
Cluster bei einem Maschinenausfall nicht heruntergefahren werden und die Ausführung des Clusters sollte es ermöglichen,
Komponenten zu reparieren oder auszutauschen, ohne Ausfallzeiten zu verursachen.
Deployment-Werkzeuge: Die Seite
Kubernetes mit Deployment-Werkzeugen installieren
bietet Anleitungen zur Bereitstellung einer produktionsreifen Steuerungsebene.
Externe Dienste: Die Steuerungsebene läuft mit den Diensten etcd, API-Server,
Scheduler und Controller-Manager, die jeweils auf verschiedenen Maschinen laufen können.
Replikation: Für hohe Verfügbarkeit kann die Steuerungsebene und ihre Dienste
über mehrere Knoten repliziert werden. Weitere Informationen finden Sie unter
Optionen für hochverfügbare Topologie.
Mehrere Zonen: Wenn es entscheidend ist, dass Ihr Cluster auch dann verfügbar bleibt,
wenn ein gesamtes Rechenzentrum oder eine Region ausfällt, sollten Sie einen Cluster in
mehreren Zonen in Betracht ziehen.
Worker-Knoten in der Produktion
Produktionsreife Workloads müssen belastbar sein, und alles, worauf sie angewiesen sind
(wie CoreDNS), muss ebenfalls belastbar sein. Unabhängig davon, ob Sie Ihre eigene
Steuerungsebene verwalten oder einen Cloud-Anbieter dies für Sie tun lassen,
müssen Sie dennoch überlegen, wie Sie Ihre Worker-Knoten verwalten möchten
(manchmal auch einfach als Knoten bezeichnet).
- Knoten konfigurieren: Knoten können physische oder virtuelle Maschinen sein. Wenn Sie
Knoten selbst erstellen und verwalten möchten, können Sie ein unterstütztes Betriebssystem
installieren und dann die entsprechenden
Knotendienste hinzufügen und ausführen.
- Knoten validieren: Informationen dazu, wie Sie sicherstellen können, dass ein Knoten
die Anforderungen für den Beitritt zu einem Kubernetes-Cluster erfüllt, finden Sie unter
Knoteneinrichtung validieren.
- Knoten zum Cluster hinzufügen: Wenn Sie den Cluster selbst verwalten, können Sie
Knoten hinzufügen, indem Sie Ihre eigenen Maschinen einrichten und sie entweder manuell
hinzufügen oder sie sich beim API-Server des Clusters registrieren lassen. Informationen
zum Einrichten von Knoten finden Sie im Abschnitt Knoten.
- Knoten skalieren: Haben Sie einen Plan, um die Kapazität zu erweitern, die Ihr Cluster
letztendlich benötigen wird. Siehe Überlegungen für große Cluster,
um zu bestimmen, wie viele Knoten Sie benötigen, basierend auf der Anzahl der Pods und
Container, die Sie ausführen müssen.
- Knoten automatisch skalieren: Die meisten Cloud-Anbieter unterstützen den
Cluster Autoscaler,
um überlastete Knoten durch neue Knoten zu ersetzen. Weitere Informationen finden Sie unter
Knoten-Autoskalierung
und zur Dimensionierung von Knotengruppen lesen Sie
Sizing a node group.
Benutzerverwaltung in der Produktion
In der Produktion gehen Sie möglicherweise von einem Modell, in dem Sie oder eine kleine Gruppe
auf den Cluster zugreift, zu einem Modell über, in dem möglicherweise Dutzende oder Hunderte
von Personen Zugriff benötigen. In einer Lern- oder Plattformentwicklungsumgebung haben Sie
möglicherweise ein einzelnes Administratorkonto für alles, was Sie tun. In der Produktion
benötigen Sie mehr Konten mit unterschiedlichen Zugriffsebenen auf verschiedene Namespaces.
Die Einrichtung eines produktionsreifen Clusters bedeutet, zu entscheiden, wie Sie
selektiven Zugriff auf Cluster-Ressourcen gewähren möchten. Insbesondere müssen Sie
die folgenden Strategien auswählen und umsetzen:
- Authentifizierung: Der API-Server kann Benutzer mit Client-Zertifikaten,
Bearer-Token, einem Authentifizierungsproxy oder HTTP-Basisauthentifizierung authentifizieren.
Sie können die Authentifizierungsmethoden auswählen, die Sie verwenden möchten. Mithilfe von
Plugins kann der API-Server die vorhandene Benutzerverwaltungsmethode Ihres
Unternehmens nutzen, wie LDAP oder Kerberos. Verschiedene Methoden zur
Authentifizierung von Kubernetes-Benutzern finden Sie unter
Authentifizierung.
- Autorisierung: Wenn Sie Ihre regulären Benutzer autorisieren, werden Sie wahrscheinlich
zwischen RBAC- und ABAC-Autorisierung wählen. Informationen zu verschiedenen Modi der
Autorisierung von Benutzerkonten (und des Zugriffs auf Dienstkonten in Ihrem Cluster) finden Sie unter
Autorisierungsübersicht:
- Rollenbasierte Zugriffskontrolle (RBAC):
Ermöglicht die Zuweisung von Zugriffsrechten an authentifizierte Benutzer. Berechtigungen können
für einen bestimmten Namespace (Role) oder clusterübergreifend (ClusterRole) zugewiesen werden.
Anschließend können mithilfe von RoleBindings und ClusterRoleBindings diese Berechtigungen
bestimmten Benutzern zugeordnet werden.
- Attributbasierte Zugriffskontrolle (ABAC):
Ermöglicht die Erstellung von Richtlinien basierend auf Ressourcenattributen im Cluster
und erlaubt oder verweigert den Zugriff basierend auf diesen Attributen.
Als Administrator, der eine Kubernetes-Produktionsumgebung einrichtet, sind hier
einige Dinge zu beachten:
- Autorisierungsmodus festlegen: Wenn der Kubernetes-API-Server
(kube-apiserver) gestartet wird,
müssen die unterstützten Autorisierungsmodi mit dem Flag --authorization-mode festgelegt werden.
Zum Beispiel wird das Flag in der Datei kube-apiserver.yaml
(in /etc/kubernetes/manifests) auf node,rbac gesetzt. Dies ermöglicht
Knoten- und RBAC-Autorisierung für authentifizierte Anfragen.
- Benutzer-Zertifikate und Rollen-Bindings erstellen (RBAC): Wenn Sie RBAC-Autorisierung
verwenden, können Benutzer ein CertificateSigningRequest (CSR) erstellen, das von
der Cluster-CA signiert werden kann. Dann können Sie Rollen und ClusterRoles an
jeden Benutzer binden. Siehe
Zertifikats-Signieranfragen
für weitere Informationen.
- Richtlinien erstellen, die Attribute kombinieren (ABAC): Wenn Sie ABAC-Autorisierung
verwenden, können Sie Kombinationen von Attributen zuweisen, um Richtlinien zu erstellen, die
ausgewählte Benutzer oder Gruppen autorisieren, auf bestimmte Ressourcen (z.B. einen Pod),
Namespaces oder apiGroups zuzugreifen. Weitere Informationen finden Sie in der
ABAC-Autorisierung.
- Admission Controller in Betracht ziehen:
Admission Controller
sind Plugins, die Anfragen an den Kubernetes-API-Server
abfangen. Eine häufige Verwendung von Admission Controllern ist die Einschränkung
von Anfragen zum Erstellen, Löschen und Ändern von Kubernetes-Objekten. Admission Controller
können den Umfang einer Anfrage auch erweitern, wenn sie mit Webhooks arbeiten.
Grenzen für Workload-Ressourcen setzen
Die Anforderungen von Produktions-Workloads können sowohl innerhalb als auch außerhalb der
Kubernetes-Steuerungsebene Druck erzeugen. Berücksichtigen Sie diese Punkte, wenn Sie
die Anforderungen der Workloads Ihres Clusters konfigurieren:
- Namespace-Grenzen setzen: Setzen Sie Quoten für Dinge wie Speicher und CPU
pro Namespace. Siehe Speicher-, CPU- und API-Ressourcen verwalten
für Details. Sie können auch hierarchische Namespaces
einrichten, um Grenzen zu vererben.
- DNS-Anfragen vorbereiten: Wenn Sie erwarten, dass Workloads massiv skalieren, muss auch
Ihr DNS-Dienst skalieren. Siehe
DNS-Dienst im Cluster automatisch skalieren.
- Zusätzliche Dienstkonten erstellen: Benutzerkonten bestimmen, was Benutzer in einem
Cluster tun können, während ein Dienstkonto den Pod-Zugriff innerhalb eines bestimmten
Namespaces definiert. Standardmäßig übernimmt ein Pod das Standard-Dienstkonto seines Namespaces.
Informationen zum Erstellen eines neuen Dienstkontos finden Sie unter
Dienstkonten verwalten.
Sie können beispielsweise Folgendes tun:
Nächste Schritte
3.1 - Überlegungen für große Cluster
Ein Cluster ist ein Satz von Nodes (physikalisch oder virtuell), auf denen Kubernetes-Agents laufen.
Diese ermöglichen es der Kubernetes-Control Plane, die Nodes zu steuern.
Kubernetes v1.37 unterstützt Cluster mit bis zu 5000 Nodes. Genauer gesagt ist Kubernetes auf folgende Konfigurationen ausgelegt:
- Nicht mehr als 110 Pods pro Node
- Nicht mehr als 5000 Nodes
- Nicht mehr als 150000 Pods insgesamt
- Nicht mehr als 300000 Container insgesamt
Ein Cluster kann skaliert werden, indem weitere Nodes hinzugefügt werden. Wie man Nodes hinzufügen kann, hängt von der Art und Weise ab, wie das Cluster initial aufgesetzt wurde.
Ressourcenlimits von Cloud-Providern
Um Probleme mit Quota von Cloud-Providern zu vermeiden, sollten Sie bei der Erstellung eines Clusters mit vielen Nodes Folgendes in Betracht ziehen:
- Beantragen Sie eine Erhöhung der Quota für Cloud-Ressourcen wie:
- Compute-Instanzen
- CPUs
- Speichervolumes
- Verwendete IP-Adressen
- Regelwerke zur Paketfilterung
- Anzahl der Load Balancer
- Netzwerk-Subnetze
- Log-Streams
- Skalierungsaktionen in Batches durchzuführen, mit einer Pause zwischen den Batches, da einige Cloud-Provider die Erstellung neuer Instanzen mit Rate Limits versehen.
Komponenten der Control Plane
Für ein großes Cluster benötigen Sie eine Control Plane mit ausreichenden Rechen- und weiteren Ressourcen.
Typischerweise betreiben Sie eine oder zwei Control-Plane-Instanzen pro Ausfallzone, wobei Sie diese Instanzen zunächst vertikal skalieren und anschließend horizontal erweitern, wenn vertikale Skalierung keine Verbesserungen mehr bringt.
Sie sollten mindestens eine Instanz pro Ausfallzone betreiben, um Fehlertoleranz zu gewährleisten.
Kubernetes-Nodes leiten den Datenverkehr nicht automatisch zu Control-Plane-Endpunkten in derselben Ausfallzone um; allerdings könnte Ihr Cloud-Provider eigene Mechanismen hierfür anbieten.
Beispielsweise können Sie mit einem Managed Load Balancer den Datenverkehr, der von Kubelets und Pods in der Ausfallzone A stammt, so konfigurieren, dass er nur an die Control-Plane-Hosts in Zone A weitergeleitet wird.
Fällt ein einzelner Control-Plane-Host oder ein Endpunkt in Zone A aus, bedeutet das, dass der gesamte Control-Plane-Datenverkehr der Nodes in Zone A nun zwischen den Zonen geleitet wird.
Mehrere Control-Plane-Hosts in jeder Zone reduzieren die Wahrscheinlichkeit dieses Szenarios.
etcd-Speicher
Um die Leistung großer Cluster zu verbessern, können Sie Event-Objekte in einer separaten, dedizierten etcd-Instanz speichern.
Bei der Erstellung eines Clusters können Sie (mit benutzerdefinierten Tools):
- eine zusätzliche etcd-Instanz starten und konfigurieren
- den API-Server so konfigurieren, dass er diese Instanz zur Speicherung von Ereignissen nutzt
Siehe Betrieb von etcd-Clustern für Kubernetes und
Einrichten eines hochverfügbaren etcd-Clusters mit kubeadm für Details zur Konfiguration und Verwaltung von etcd für große Cluster.
Addon-Ressourcen
Kubernetes-Ressourcenlimits helfen dabei, die Auswirkungen von Speicherlecks und anderer Probleme zu minimieren,
bei denen Pods und Container andere Komponenten beeinträchtigen können.
Diese Ressourcenlimits gelten auch für Addons ebenso wie für Anwendungs-Workloads.
Beispielsweise können Sie CPU- und Speicherlimits für eine Logging-Komponente festlegen:
  ...
  containers:
  - name: fluentd-cloud-logging
    image: fluent/fluentd-kubernetes-daemonset:v1
    resources:
      limits:
        cpu: 100m
        memory: 200Mi
Die Standardlimits von Addons basieren in der Regel auf Daten, die aus dem Betrieb auf kleinen oder mittleren Kubernetes-Clustern gesammelt wurden.
Bei großen Clustern verbrauchen Addons oft mehr Ressourcen als ihre Standardlimits.
Wenn ein großer Cluster ohne Anpassung dieser Werte bereitgestellt wird, können Addons kontinuierlich beendet werden, da sie ihr Speicherlimit überschreiten.
Alternativ laufen die Addons zwar, liefern aber eine schlechte Performance aufgrund von CPU-Zeit-Slice-Beschränkungen.
Um Probleme mit Addon-Ressourcen in großen Clustern zu vermeiden, sollten Sie Folgendes beachten:
- Einige Addons skalieren vertikal – es gibt eine Replik des Addons für das Cluster oder für eine gesamte Ausfallzone. Für diese Addons sollten Sie Anfragen und Limits erhöhen, wenn Sie Ihr Cluster erweitern.
- Viele Addons skalieren horizontal – Sie erhöhen die Kapazität, indem Sie mehr Pods ausführen – aber bei einem sehr großen Cluster müssen Sie möglicherweise auch die CPU- oder Speicherlimits leicht anheben. Der Vertical Pod Autoscaler kann im Recommender-Modus ausgeführt werden, um empfohlene Werte für Anfragen und Limits bereitzustellen.
- Einige Addons laufen als eine Instanz pro Node, gesteuert durch ein DaemonSet, z. B. ein Node-level Log-Aggregator. Ähnlich wie bei horizontal skalierten Addons müssen Sie eventuell CPU- oder Speicherlimits leicht erhöhen.
Nächste Schritte
VerticalPodAutoscaler ist eine benutzerdefinierte Ressource, die Sie in Ihr Cluster deployen können, um Ressourcenanforderungen und Limits für Pods zu verwalten.
Erfahren Sie mehr über den Vertical Pod Autoscaler und wie Sie ihn nutzen können,
um Cluster-Komponenten einschließlich clusterkritischer Addons zu skalieren.
Lesen Sie mehr über Node-Autoscaling
Addon Resizer unterstützt Sie dabei, die Addons automatisch an die Clustergröße anzupassen.
3.2 - PKI Zertifikate and Anforderungen
Kubernetes benötigt PKI Zertifikate für die Authentifzierung über TLS.
Falls Sie Kubernetes über kubeadm installieren,
wurden die benötigten Zertifikate bereits automatisch generiert.
In jedem Fall können Sie diese auch selbst generieren -- beispielsweise um private Schlüssel
nicht auf dem API Server zu speichern und somit deren Sicherheit zu erhöhen.
Diese Seite erklärt, welche Zertifikate ein Cluster benötigt.
Wie Zertifikate in Ihrem Cluster verwendet werden
Kubernetes benötigt PKI-Zertifikate für die folgenden Vorgänge:
Server Zertifikate
- Server Zertifikate für den API Server Endpunkt
- Server Zertifikate für den etcd Server
- Server Zertifikate
für jeden kubelet (every node runs a kubelet)
- Optionale Server Zertifikate für den front-proxy
Client Zertifikate
- Client-Zertifikate für jedes
Kubelet zur Authentifizierung gegenüber dem API-Server als Client der Kubernetes API - Client-Zertifikat für jeden
API-Server zur Authentifizierung gegenüber etcd - Client-Zertifikat für den
Controller Manager zur sicheren Kommunikation mit dem API-Server - Client-Zertifikat für den
Scheduler zur sicheren Kommunikation mit dem API-Server - Client-Zertifikate, eines pro Node, für
kube-proxy zur Authentifizierung gegenüber dem API-Server - Optionale Client-Zertifikate für Administratoren des Clusters zur Authentifizierung gegenüber dem API-Server
- Optionales Client-Zertifikat für den Front-Proxy
Server- und Client-Zertifikate des Kubelets
Um eine sichere Verbindung herzustellen und sich gegenüber dem Kubelet zu authentifizieren, benötigt der API-Server ein Client-Zertifikat und ein Schlüsselpaar.
In diesem Szenario gibt es zwei Ansätze für die Verwendung von Zertifikaten:
Gemeinsame Zertifikate: Der kube-apiserver kann dasselbe Zertifikat und Schlüsselpaar verwenden, das er zur Authentifizierung seiner Clients nutzt.
Das bedeutet, dass bestehende Zertifikate wie apiserver.crt und apiserver.key für die Kommunikation mit den Kubelet-Servern verwendet werden können.
Separate Zertifikate: Alternativ kann der kube-apiserver ein neues Client-Zertifikat und Schlüsselpaar zur Authentifizierung seiner Kommunikation mit den Kubelet-Servern generieren.
In diesem Fall werden ein separates Zertifikat kubelet-client.crt und der dazugehörige private Schlüssel kubelet-client.key erstellt.
Hinweis:
front-proxy-Zertifikate werden nur benötigt, wenn kube-proxy zur Unterstützung eines
Erweiterungs-API-Servers eingesetzt wird.
Auch etcd verwendet gegenseitiges TLS zur Authentifizierung von Clients und deren Gegenstelle.
Wo Zertifikate gespeichert werden
Wenn Sie Kubernetes mit kubeadm installieren, werden die meisten Zertifikate im Verzeichnis /etc/kubernetes/pki gespeichert.
Alle Pfade in dieser Dokumentation beziehen sich auf dieses Verzeichnis,
mit Ausnahme der Benutzerzertifikate, die von kubeadm unter /etc/kubernetes ablegt werden.
Zertifikate manuell konfigurieren
Wenn Sie nicht möchten, dass kubeadm die benötigten Zertifikate generiert,
können Sie diese entweder mithilfe einer einzelnen Root-CA selbst erstellen
oder alle Zertifikate vollständig manuell bereitstellen. Details zur Erstellung einer eigenen Zertifizierungsstelle finden Sie unter Zertifikate.
Weitere Informationen zur Verwaltung von Zertifikaten mit kubeadm bietet Zertifikatsverwaltung mit kubeadm.
Einzelne Root-CA
Sie können eine einzelne Root-CA erstellen, welche dann mehrere Zwischen-CAs generieren
und die Erstellung weiterer Zertifikate Kubernetes selbst überlassen kann.
Erforderliche CAs:
| Pfad | Standard-CN | Beschreibung |
|---|
| ca.crt,key | kubernetes-ca | Allgemeine CA für Kubernetes |
| etcd/ca.crt,key | etcd-ca | Für alle etcd-bezogenen Funktionen |
| front-proxy-ca.crt,key | kubernetes-front-proxy-ca | Für den Front-Proxy |
Zusätzlich zu den oben genannten CAs wird auch ein öffentliches/privates Schlüsselpaar für das Service-Account-Management benötigt: sa.key und sa.pub.
Das folgende Beispiel zeigt die CA-Schlüssel- und Zertifikatsdateien aus der vorherigen Tabelle:
/etc/kubernetes/pki/ca.crt
/etc/kubernetes/pki/ca.key
/etc/kubernetes/pki/etcd/ca.crt
/etc/kubernetes/pki/etcd/ca.key
/etc/kubernetes/pki/front-proxy-ca.crt
/etc/kubernetes/pki/front-proxy-ca.key
Alle Zertifikate
Wenn Sie die privaten CA-Schlüssel nicht in Ihren Cluster kopieren möchten, können Sie alle Zertifikate selbst generieren.
Erforderliche Zertifikate:
| Standard-CN | Ausstellende CA | O (im Subject) | Typ | Hosts (SAN) |
|---|
| kube-etcd | etcd-ca | | Server, Client | <hostname>, <Host_IP>, localhost, 127.0.0.1 |
| kube-etcd-peer | etcd-ca | | Server, Client | <hostname>, <Host_IP>, localhost, 127.0.0.1 |
| kube-etcd-healthcheck-client | etcd-ca | | Client | |
| kube-apiserver-etcd-client | etcd-ca | | Client | |
| kube-apiserver | kubernetes-ca | | Server | <hostname>, <Host_IP>, <advertise_IP> |
| kube-apiserver-kubelet-client | kubernetes-ca | system:masters | Client | |
| front-proxy-client | kubernetes-front-proxy-ca | | Client | |
Hinweis:
Anstelle der Superuser-Gruppe system:masters für kube-apiserver-kubelet-client kann auch eine weniger privilegierte Gruppe verwendet werden. kubeadm nutzt hierfür die Gruppe kubeadm:cluster-admins.Der Wert in der Spalte Typ entspricht einer oder mehreren x509-Schlüsselverwendungen, die auch in .spec.usages eines CertificateSigningRequest-Typs dokumentiert sind:
| Typ | Schlüsselverwendung |
|---|
| Server | Digitale Signatur, Schlüsselverschlüsselung, Serverauth. |
| Client | Digitale Signatur, Schlüsselverschlüsselung, Clientauth. |
Hinweis:
Die oben aufgelisteten Hosts/SANs sind die empfohlenen Werte, um einen funktionsfähigen Cluster zu erhalten.
Falls Ihr Setup es erfordert, können Sie auf allen Server-Zertifikaten zusätzliche SANs ergänzen.Hinweis:
Nur für kubeadm-Benutzer:
- Das Szenario, bei dem Sie CA-Zertifikate ohne private Schlüssel in Ihren Cluster kopieren, wird in der kubeadm-Dokumentation als externe CA bezeichnet.
- Wenn Sie die obige Liste mit einer von kubeadm generierten PKI vergleichen, beachten Sie bitte, dass
kube-etcd, kube-etcd-peer und kube-etcd-healthcheck-client nicht erzeugt werden, wenn ein externer etcd-Cluster verwendet wird.
Zertifikatspfade
Zertifikate sollten in einem empfohlenen Pfad abgelegt werden (wie von kubeadm verwendet).
Die Pfade sollten mit dem angegebenen Argument festgelegt werden, unabhängig vom Speicherort.
| Standard-CN | Empfohlener Schlüsselpfad | Empfohlener Zertifikatspfad | Befehl | Schlüssel-Argument | Zertifikat-Argument |
|---|
| etcd-ca | etcd/ca.key | etcd/ca.crt | kube-apiserver | | --etcd-cafile |
| kube-apiserver-etcd-client | apiserver-etcd-client.key | apiserver-etcd-client.crt | kube-apiserver | --etcd-keyfile | --etcd-certfile |
| kubernetes-ca | ca.key | ca.crt | kube-apiserver | | --client-ca-file |
| kubernetes-ca | ca.key | ca.crt | kube-controller-manager | --cluster-signing-key-file | --client-ca-file,--root-ca-file,--cluster-signing-cert-file |
| kube-apiserver | apiserver.key | apiserver.crt | kube-apiserver | --tls-private-key-file | --tls-cert-file |
| kube-apiserver-kubelet-client | apiserver-kubelet-client.key | apiserver-kubelet-client.crt | kube-apiserver | --kubelet-client-key | --kubelet-client-certificate |
| front-proxy-ca | front-proxy-ca.key | front-proxy-ca.crt | kube-apiserver | | --requestheader-client-ca-file |
| front-proxy-ca | front-proxy-ca.key | front-proxy-ca.crt | kube-controller-manager | | --requestheader-client-ca-file |
| front-proxy-client | front-proxy-client.key | front-proxy-client.crt | kube-apiserver | --proxy-client-key-file | --proxy-client-cert-file |
| etcd-ca | etcd/ca.key | etcd/ca.crt | etcd | | --trusted-ca-file,--peer-trusted-ca-file |
| kube-etcd | etcd/server.key | etcd/server.crt | etcd | --key-file | --cert-file |
| kube-etcd-peer | etcd/peer.key | etcd/peer.crt | etcd | --peer-key-file | --peer-cert-file |
| etcd-ca | | etcd/ca.crt | etcdctl | | --cacert |
| kube-etcd-healthcheck-client | etcd/healthcheck-client.key | etcd/healthcheck-client.crt | etcdctl | --key | --cert |
Gleiche Überlegungen gelten für das Service-Account-Schlüsselpaar:
| Pfad privater Schlüssel | Pfad öffentlicher Schlüssel | Befehl | Argument |
|---|
| sa.key | | kube-controller-manager | --service-account-private-key-file |
| sa.pub | kube-apiserver | --service-account-key-file |
Das folgende Beispiel zeigt die Dateipfade aus den vorherigen Tabellen, die Sie bereitstellen müssen, wenn Sie alle Schlüssel und Zertifikate selbst generieren:
/etc/kubernetes/pki/etcd/ca.key
/etc/kubernetes/pki/etcd/ca.crt
/etc/kubernetes/pki/apiserver-etcd-client.key
/etc/kubernetes/pki/apiserver-etcd-client.crt
/etc/kubernetes/pki/ca.key
/etc/kubernetes/pki/ca.crt
/etc/kubernetes/pki/apiserver.key
/etc/kubernetes/pki/apiserver.crt
/etc/kubernetes/pki/apiserver-kubelet-client.key
/etc/kubernetes/pki/apiserver-kubelet-client.crt
/etc/kubernetes/pki/front-proxy-ca.key
/etc/kubernetes/pki/front-proxy-ca.crt
/etc/kubernetes/pki/front-proxy-client.key
/etc/kubernetes/pki/front-proxy-client.crt
/etc/kubernetes/pki/etcd/server.key
/etc/kubernetes/pki/etcd/server.crt
/etc/kubernetes/pki/etcd/peer.key
/etc/kubernetes/pki/etcd/peer.crt
/etc/kubernetes/pki/etcd/healthcheck-client.key
/etc/kubernetes/pki/etcd/healthcheck-client.crt
/etc/kubernetes/pki/sa.key
/etc/kubernetes/pki/sa.pub
Zertifikate für Benutzerkonten konfigurieren
Sie müssen diese Administrator- und Servicekonten manuell konfigurieren:
| Dateiname | Anmeldeinformationen-Name | Standard-CN | O (im Subject) |
|---|
| admin.conf | default-admin | kubernetes-admin | <admin-group> |
| super-admin.conf | default-super-admin | kubernetes-super-admin | system:masters |
| kubelet.conf | default-auth | system:node:<nodeName> (siehe Hinweis) | system:nodes |
| controller-manager.conf | default-controller-manager | system:kube-controller-manager | |
| scheduler.conf | default-scheduler | system:kube-scheduler | |
Hinweis:
Der Wert von
<nodeName> in
kubelet.conf muss exakt mit dem Node-Namen übereinstimmen, den der kubelet beim Registrieren am apiserver angibt.
Weitere Details finden Sie unter
Node Authorization.
Hinweis:
Im obigen Beispiel ist <admin-group> implementierungsspezifisch. Manche Tools signieren das Zertifikat in der Standard-admin.conf, sodass es Teil der Gruppe system:masters ist.
system:masters ist eine Notfall-Superuser-Gruppe, die die Autorisierungsschicht, wie zum Beispiel RBAC, von Kubernetes umgehen kann. Manche Tools erzeugen auch keine separate super-admin.conf mit einem Zertifikat, das an diese Superuser-Gruppe gebunden ist.
kubeadm erstellt zwei separate Administratorzertifikate in kubeconfig-Dateien. Eines ist in admin.conf und hat Subject: O = kubeadm:cluster-admins, CN = kubernetes-admin.
kubeadm:cluster-admins ist eine benutzerdefinierte Gruppe, die an die ClusterRole cluster-admin gebunden ist. Diese Datei wird auf allen von kubeadm verwalteten Control-Plane-Maschinen erstellt.
Das andere ist in super-admin.conf und hat Subject: O = system:masters, CN = kubernetes-super-admin.
Diese Datei wird nur auf dem Node erzeugt, auf dem kubeadm init ausgeführt wurde.
Generieren Sie für jede Konfiguration ein x509-Zertifikat/Schlüsselpaar mit dem angegebenen Common Name (CN) und der Organisation (O).
Führen Sie für jede Konfiguration kubectl wie folgt aus:
KUBECONFIG=<Dateiname> kubectl config set-cluster default-cluster --server=https://<Host-IP>:6443 --certificate-authority <Pfad-zur-kubernetes-ca> --embed-certs
KUBECONFIG=<Dateiname> kubectl config set-credentials <Anmeldeinfo-Name> --client-key <Pfad-zum-Schlüssel>.pem --client-certificate <Pfad-zum-Zertifikat>.pem --embed-certs
KUBECONFIG=<Dateiname> kubectl config set-context default-system --cluster default-cluster --user <Anmeldeinfo-Name>
KUBECONFIG=<Dateiname> kubectl config use-context default-system
Diese Dateien werden wie folgt verwendet:
| Dateiname | Befehl | Kommentar |
|---|
| admin.conf | kubectl | Konfiguriert den Administrator-Benutzer für den Cluster |
| super-admin.conf | kubectl | Konfiguriert den Super-Administrator-Benutzer für den Cluster |
| kubelet.conf | kubelet | Wird für jeden Node im Cluster benötigt |
| controller-manager.conf | kube-controller-manager | Muss im Manifest manifests/kube-controller-manager.yaml eingetragen werden |
| scheduler.conf | kube-scheduler | Muss im Manifest manifests/kube-scheduler.yaml eingetragen werden |
Beispielhafte vollständige Pfade zu den Dateien aus der obigen Tabelle:
/etc/kubernetes/admin.conf
/etc/kubernetes/super-admin.conf
/etc/kubernetes/kubelet.conf
/etc/kubernetes/controller-manager.conf
/etc/kubernetes/scheduler.conf
4 - Kubernetes lokal über Minikube betreiben
Minikube ist ein Tool, mit dem Kubernetes lokal einfach ausgeführt werden kann. Minikube führt einen Kubernetes-Cluster mit einem einzigen Node in einer VM auf Ihrem Laptop aus, damit Anwender Kubernetes ausprobieren oder täglich damit entwickeln können.
Minikube-Funktionen
- Minikube unterstützt Kubernetes-Funktionen wie:
- DNS
- NodePorts
- ConfigMaps and Secrets
- Dashboards
- Container Laufzeiumgebungen: Docker, rkt, CRI-O und containerd
- Unterstützung von CNI (Container Network Interface)
- Ingress
Installation
Lesen Sie Minikube installieren für Informationen zur Installation von Minikubes.
Schnellstart
Folgend finden Sie eine kurze Demo zur Verwendung von Minikube.
Wenn Sie den VM-Treiber ändern möchten, fügen Sie das entsprechende --vm-driver=xxx-Flag zu minikube start hinzu.
Minikube unterstützt die folgenden Treiber:
Starting local Kubernetes cluster...
Running pre-create checks...
Creating machine...
Starting local Kubernetes cluster...
kubectl create deployment hello-minikube --image=registry.k8s.io/echoserver:1.10
deployment.apps/hello-minikube created
kubectl expose deployment hello-minikube --type=NodePort --port=8080
service/hello-minikube exposed
# Wir haben jetzt einen echoserver Pod gestartet, aber wir müssen warten,
# bis der Pod betriebsbereit ist, bevor wir über den exponierten Dienst auf ihn zugreifen können.
# Um zu überprüfen, ob der Pod läuft, können wir Folgendes verwenden:
kubectl get pod
NAME                              READY     STATUS              RESTARTS   AGE
hello-minikube-3383150820-vctvh   0/1       ContainerCreating   0          3s
# Wir können anhand des ContainerCreating-Status sehen, dass der Pod immer noch erstellt wird.
kubectl get pod
NAME                              READY     STATUS    RESTARTS   AGE
hello-minikube-3383150820-vctvh   1/1       Running   0          13s
# Wir können sehen, dass der Pod jetzt läuft und wir können ihn jetzt mit curl kontaktieren:
curl $(minikube service hello-minikube --url)
Hostname: hello-minikube-7c77b68cff-8wdzq

Pod Information:
	-no pod information available-

Server values:
	server_version=nginx: 1.13.3 - lua: 10008

Request Information:
	client_address=172.17.0.1
	method=GET
	real path=/
	query=
	request_version=1.1
	request_scheme=http
	request_uri=http://192.168.99.100:8080/

Request Headers:
	accept=*/*
	host=192.168.99.100:30674
	user-agent=curl/7.47.0

Request Body:
	-no body in request-
kubectl delete services hello-minikube
service "hello-minikube" deleted
kubectl delete deployment hello-minikube
deployment.extensions "hello-minikube" deleted
Stopping local Kubernetes cluster...
Stopping "minikube"...
Alternative Containerlaufzeitumgebungen
containerd
Um containerd als Containerlaufzeitumgebung zu verwenden, führen Sie den folgenden Befehl aus:
minikube start \
    --network-plugin=cni \
    --enable-default-cni \
    --container-runtime=containerd \
    --bootstrapper=kubeadm
Oder verwenden Sie die erweiterte Version:
minikube start \
    --network-plugin=cni \
    --enable-default-cni \
    --extra-config=kubelet.container-runtime=remote \
    --extra-config=kubelet.container-runtime-endpoint=unix:///run/containerd/containerd.sock \
    --extra-config=kubelet.image-service-endpoint=unix:///run/containerd/containerd.sock \
    --bootstrapper=kubeadm
CRI-O
Um CRI-O als Containerlaufzeitumgebung zu verwenden, führen Sie den folgenden Befehl aus:
minikube start \
    --network-plugin=cni \
    --enable-default-cni \
    --container-runtime=cri-o \
    --bootstrapper=kubeadm
Oder verwenden Sie die erweiterte Version:
minikube start \
    --network-plugin=cni \
    --enable-default-cni \
    --extra-config=kubelet.container-runtime=remote \
    --extra-config=kubelet.container-runtime-endpoint=/var/run/crio.sock \
    --extra-config=kubelet.image-service-endpoint=/var/run/crio.sock \
    --bootstrapper=kubeadm
rkt container engine
Um rkt als Containerlaufzeitumgebung zu verwenden, führen Sie den folgenden Befehl aus:
minikube start \
    --network-plugin=cni \
    --enable-default-cni \
    --container-runtime=rkt
Hierbei wird ein alternatives Minikube-ISO-Image verwendet, das sowohl rkt als auch Docker enthält, und CNI-Netzwerke ermöglichen.
Treiber Plugins
Weitere Informationen zu unterstützten Treibern und zur Installation von Plugins finden Sie bei Bedarf unter TREIBER.
Lokale Images durch erneute Verwendung des Docker-Daemon ausführen
Wenn Sie eine einzige Kubernetes VM verwenden, ist es sehr praktisch, den integrierten Docker-Daemon von Minikube wiederzuverwenden; Dies bedeutet, dass Sie auf Ihrem lokalen Computer keine Docker-Registy erstellen und das Image in die Registry importieren müssen - Sie können einfach innerhalb desselben Docker-Daemons wie Minikube arbeiten, was lokale Experimente beschleunigt. Stellen Sie einfach sicher, dass Sie Ihr Docker-Image mit einem anderen Element als 'latest' versehen, und verwenden Sie dieses Tag, wenn Sie das Image laden. Andernfalls, wenn Sie keine Version Ihres Images angeben, wird es als :latest angenommen, mit der Pull-Image-Richtlinie von Always entsprechend, was schließlich zu ErrImagePull führen kann, da Sie möglicherweise noch keine Versionen Ihres Docker-Images in der Standard-Docker-Registry (normalerweise DockerHub) haben.
Um mit dem Docker-Daemon auf Ihrem Mac/Linux-Computer arbeiten zu können, verwenden Sie den docker-env-Befehl in Ihrer Shell:
eval $(minikube docker-env)
Sie sollten nun Docker in der Befehlszeile Ihres Mac/Linux-Computers verwenden können, um mit dem Docker-Daemon in der Minikube-VM zu sprechen:
In Centos 7 meldets Docker möglicherweise den folgenden Fehler:
Could not read CA certificate "/etc/docker/ca.pem": open /etc/docker/ca.pem: no such file or directory
Das Update besteht darin, /etc/sysconfig/docker zu aktualisieren, um sicherzustellen, dass die Umgebungsänderungen von Minikube beachtet werden:
< DOCKER_CERT_PATH=/etc/docker
---
> if [ -z "${DOCKER_CERT_PATH}" ]; then
>   DOCKER_CERT_PATH=/etc/docker
> fi
Denken Sie daran, imagePullPolicy: Always auszuschalten. Andernfalls verwendet Kubernetes keine lokal erstellten Images.
Cluster verwalten
Cluster starten
Mit dem Befehl minikube start können Sie Ihr Cluster starten.
Dieser Befehl erstellt und konfiguriert eine virtuelle Maschine, auf der ein Kubernetes-Cluster mit einem Knoten ausgeführt wird.
Ebenfalls konfiguriert dieser Befehl auch Ihre kubectl Installation zur Kommunikation mit diesem Cluster.
Wenn Sie sich hinter einem Web-Proxy befinden, müssen Sie diese Informationen mit dem Befehl minikube start übergeben:
https_proxy=<mein_proxy> minikube start --docker-env http_proxy=<mein_proxy> --docker-env https_proxy=<mein_proxy> --docker-env no_proxy=192.168.99.0/24
Leider wird nur das Setzen der Umgebungsvariablen nicht funktionieren.
Minikube erstellt auch einen "Minikube"-Kontext und setzt ihn in kubectl auf den Standardwert.
Um später wieder zu diesem Kontext zurückzukehren, führen Sie den folgenden Befehl aus: kubectl config use-context minikube.
Angabe der Kubernetes-Version
Sie können die bestimmte Version von Kubernetes für Minikube angeben, indem Sie die Zeichenfolge --kubernetes-version an den Befehl minikube start anhängen.
Zum Verwenden der Version v1.7.3 führen Sie beispielsweise Folgendes aus:
minikube start --kubernetes-version v1.7.3
Kubernetes konfigurieren
Minikube verfügt über eine "Konfigurator"-Funktion, mit der Anwender die Kubernetes-Komponenten mit beliebigen Werten konfigurieren können.
Um diese Funktion zu verwenden, setzen Sie das --extra-config-Flag an den minikube start Befehl.
Dieses Flag wird wiederholt, sodass Sie es mehrere Male mit verschiedenen Werten übergeben können, um mehrere Optionen festzulegen.
Dieses Flag nimmt eine Zeichenkette der Form component.key=value an, wobei component eine der Zeichenketten aus der unteren Liste ist, key ein Wert in der Konfigurationsstruktur ist und value der einzustellende Wert ist.
Gültige Schlüssel finden Sie in der Dokumentation der Kubernetes componentconfigs für jede Komponente.
Nachstehend die Dokumentation für jede unterstützte Konfiguration:
Beispiele
Um die MaxPods-Einstellung im Kubelet auf 5 zu ändern, übergeben Sie dieses Flag: --extra-config=kubelet.MaxPods=5.
Diese Funktion unterstützt auch verschachtelte Strukturen. Um die LeaderElection.LeaderElect Einstellung zu true zu ändern, übergeben Sie im Scheduler dieses Flag: --extra-config=scheduler.LeaderElection.LeaderElect=true.
Um den AuthorizationMode auf dem apiserver zu RBAC zu ändern, verwenden Sie: --extra-config=apiserver.authorization-mode=RBAC.
Einen Cluster stoppen
Mit dem Befehl minikube stop können Sie Ihr Cluster anhalten.
Mit diesem Befehl wird die Minikube Virtual Machine heruntergefahren, der Clusterstatus und die Clusterdaten bleiben jedoch erhalten.
Durch erneutes Starten des Clusters wird der vorherige Status wiederhergestellt.
Cluster löschen
Der Befehl minikube delete kann zum Löschen Ihres Clusters verwendet werden.
Mit diesem Befehl wird die Minikube Virtual Machine heruntergefahren und gelöscht. Keine Daten oder Zustände bleiben erhalten.
Mit einem Cluster interagieren
Kubectl
Der minikube start Befehl erstellt einen kubectl Kontext genannt "minikube".
Dieser Kontext enthält die Konfiguration für die Kommunikation mit Ihrem Minikube-Cluster.
Minikube setzt diesen Kontext automatisch auf den Standardwert, aber wenn Sie in Zukunft wieder darauf zurückgreifen müssen, führen Sie den folgenden Befehl aus:
kubectl config use-context minikube,
Oder übergeben Sie den Kontext bei jedem Befehl wie folgt: kubectl get pods --context=minikube.
Dashboard
Um Zugriff auf das Kubernetes Dashboard zu erhalten, führen Sie diesen Befehl in einer Shell aus, nachdem Sie Minikube gestartet haben, um die Adresse abzurufen:
Services
Um auf einen Service zuzugreifen, der über einen NodePort verfügbar gemacht wird, führen Sie diesen Befehl in einer Shell aus, nachdem Sie Minikube gestartet haben, um die Adresse abzurufen:
minikube service [-n NAMESPACE] [--url] NAME
Netzwerk
Die Minikube-VM wird über eine Host-Only-IP-Adresse, die mit dem Befehl minikube ip abgerufen werden kann, für das Hostsystem verfügbar gemacht.
Auf alle Dienste des Typs NodePort kann über diese IP-Adresse und den NodePort zugegriffen werden.
Um den NodePort für Ihren Dienst zu ermitteln, können Sie einen kubectl-Befehl wie folgt verwenden:
kubectl get service $SERVICE --output='jsonpath="{.spec.ports[0].nodePort}"'
Dauerhafte Volumen
Minikube unterstützt PersistentVolumes des Typs hostPath.
Diese dauerhaften Volumen werden einem Verzeichnis in der Minikube-VM zugeordnet.
Die Minikube-VM wird in ein temporäres Dateisystem hochgefahren, sodass die meisten Verzeichnisse nicht nach Neustarts beibehalten werden (minikube stop).
Minikube ist jedoch so konfiguriert, dass Dateien beibehalten werden, die in den folgenden Host-Verzeichnissen gespeichert sind:
/data/var/lib/minikube/var/lib/docker
Hier ist ein Beispiel einer PersistentVolume-Konfiguration, um Daten im Verzeichnis / data beizubehalten:
apiVersion: v1
kind: PersistentVolume
metadata:
  name: pv0001
spec:
  accessModes:
    - ReadWriteOnce
  capacity:
    storage: 5Gi
  hostPath:
    path: /data/pv0001/
Hostordnerfreigabe
Einige Treiber werden einen Hostordner in der VM bereitstellen, sodass Sie Dateien problemlos zwischen VM und Host freigeben können. Diese sind momentan nicht konfigurierbar und unterscheiden sich für den Treiber und das Betriebssystem, das Sie verwenden.
Hinweis:
Die Hostordnerfreigabe ist noch nicht im KVM-Treiber implementiert.| Treiber | Betriebssystem | Hostordner | VM |
|---|
| VirtualBox | Linux | /home | /hosthome |
| VirtualBox | macOS | /Users | /Users |
| VirtualBox | Windows | C://Users | /c/Users |
| VMware Fusion | macOS | /Users | /Users |
| Xhyve | macOS | /Users | /Users |
Private Containerregistries
Um auf eine private Container Registry zuzugreifen, führen Sie die Schritte auf dieser Seite aus.
Wir empfehlen die Verwendung von ImagePullSecrets, wenn Sie jedoch den Zugriff auf die Minikube-VM konfigurieren möchten, können Sie die Datei .dockercfg im Verzeichnis/home/docker oder die Datei config.json im Verzeichnis/home/docker/.docker ablegen.
Add-ons
Damit Minikube benutzerdefinierte Addons ordnungsgemäß starten oder neu starten kann, platzieren Sie die Addons, die mit Minikube gestartet werden sollen, im Verzeichnis ~ /.minikube/addons.
Addons in diesem Ordner werden in die Minikube-VM verschoben und jedes Mal gestartet, wenn Minikube gestartet oder neu gestartet wird.
Minikube mit einem HTTP-Proxy verwenden
Minikube erstellt eine virtuelle Maschine, die Kubernetes und einen Docker-Dämon enthält.
Wenn Kubernetes versucht, Container mithilfe von Docker zu planen, erfordert der Docker-Daemon möglicherweise einen externen Netzwerkzugriff, um Container abzurufen.
Wenn Sie sich hinter einem HTTP-Proxy befinden, müssen Sie möglicherweise die Proxy-Einstellungen für Docker angeben.
Übergeben Sie dazu die erforderlichen Umgebungsvariablen während des minikube start als Flags.
Zum Beispiel:
minikube start --docker-env http_proxy=http://$IHRPROXY:PORT \
                 --docker-env https_proxy=https://$IHRPROXY:PORT
Wenn die Adresse Ihrer virtuellen Maschine 192.168.99.100 lautet, besteht die Möglichkeit, dass Ihre Proxy-Einstellungen verhindern, dass kubectl sie direkt erreicht.
Um die Proxy-Konfiguration für diese IP-Adresse zu umgehen, sollten Sie Ihre no_proxy-Einstellungen ändern. Sie können dies mit dem folgenden Befehl tun:
export no_proxy=$no_proxy,$(minikube ip)
Bekannte Probleme
- Funktionen, die einen Cloud-Provider erfordern, funktionieren in Minikube nicht. Diese schließen ein:
- Features, die mehrere Knoten erfordern. Diese schließen ein:
- Erweiterte Planungsrichtlinien
Design
Minikube verwendet libmachine zur Bereitstellung von VMs, und kubeadm um einen Kubernetes-Cluster in Betrieb zu nehmen.
Weitere Informationen zu Minikube finden Sie im Vorschlag.
Zusätzliche Links
- Ziele und Nichtziele: Die Ziele und Nichtziele des Minikube-Projekts finden Sie in unserer Roadmap.
- Entwicklungshandbuch: Lesen Sie CONTRIBUTING.md für einen Überblick über das Senden von Pull-Requests.
- Minikube bauen: Anweisungen zum Erstellen/Testen von Minikube aus dem Quellcode finden Sie im build Handbuch.
- Neue Abhängigkeit hinzufügen: Anweisungen zum Hinzufügen einer neuen Abhängigkeit zu Minikube finden Sie in der Anleitung zum Hinzufügen von Abhängigkeiten.
- Neues Addon hinzufügen: Anweisungen zum Hinzufügen eines neuen Addons für Minikube finden Sie im Anleitung zum Hinzufügen eines Addons.
- MicroK8s: Linux-Benutzer, die die Ausführung einer virtuellen Maschine vermeiden möchten, sollten MicroK8s als Alternative in Betracht ziehen.
Beiträge, Fragen und Kommentare werden begrüßt und ermutigt! Minikube-Entwickler finden Sie in Slack im #minikube Kanal (Erhalten Sie hier eine Einladung). Wir haben ausserdem die kubernetes-dev Google Groups-Mailingliste. Wenn Sie in der Liste posten, fügen Sie Ihrem Betreff bitte "minikube:" voran.