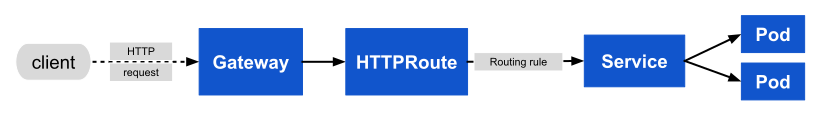
Le modèle réseau de Kubernetes repose sur plusieurs éléments :
Chaque pod d'un cluster reçoit sa propre
adresse IP, unique dans tout le cluster.
Un pod a son propre namespace réseau privé, partagé par
tous les conteneurs du pod. Les processus qui s'exécutent dans
différents conteneurs d'un même pod peuvent communiquer entre eux
via localhost.
Le réseau des pods (aussi appelé réseau du cluster) gère la communication
entre les pods. Il garantit que (sauf segmentation réseau volontaire) :
Tous les pods peuvent communiquer avec tous les autres pods, qu'ils soient
sur le même nœud ou sur
des nœuds différents. Les pods peuvent communiquer entre eux
directement, sans proxy ni traduction d'adresses (NAT).
Sous Windows, cette règle ne s'applique pas aux pods qui utilisent le réseau de l'hôte.
Les agents d'un nœud (comme les démons système ou le kubelet) peuvent
communiquer avec tous les pods de ce nœud.
L'API Service
vous permet de fournir une adresse IP ou un nom d'hôte stable (durable) pour un service mis en œuvre
par un ou plusieurs pods backend, alors que les pods qui composent
ce service peuvent changer au fil du temps.
Kubernetes gère automatiquement des objets
EndpointSlice
qui donnent des informations sur les pods qui servent actuellement de backends à un Service.
Une implémentation de proxy de service surveille l'ensemble des objets Service et
EndpointSlice, et programme le plan de données pour acheminer
le trafic des services vers leurs backends, en utilisant les API du système d'exploitation ou
du fournisseur cloud pour intercepter ou réécrire les paquets.
L'API Gateway
(ou son prédécesseur, Ingress)
vous permet de rendre des Services accessibles à des clients extérieurs au cluster.
Un mécanisme plus simple, mais moins configurable, pour faire entrer le trafic
dans le cluster est proposé par le
type: LoadBalancer de l'API Service,
si vous utilisez un fournisseur de cloud compatible.
NetworkPolicy est une API
intégrée à Kubernetes qui vous permet de contrôler le trafic entre les pods, ou entre les pods et
le monde extérieur.
Dans les anciens systèmes de conteneurs, il n'existait pas de connectivité automatique
entre les conteneurs de différents hôtes. Il fallait donc souvent
créer explicitement des liens entre les conteneurs, ou faire correspondre les ports des conteneurs
à des ports de l'hôte pour que les conteneurs d'autres hôtes puissent les joindre.
Ce n'est pas nécessaire dans Kubernetes : dans son modèle,
les pods peuvent être traités presque comme des VM ou des hôtes physiques du point de vue
de l'allocation des ports, du nommage, de la découverte de services, de l'équilibrage
de charge, de la configuration des applications et de la migration.
Seules quelques parties de ce modèle sont mises en œuvre par Kubernetes lui-même.
Pour les autres, Kubernetes définit les API, mais la
fonctionnalité correspondante est fournie par des composants externes, dont certains
sont facultatifs :
La mise en place du namespace réseau des pods est assurée par un logiciel système qui implémente
la Container Runtime Interface.
Le réseau des pods lui-même est géré par une
implémentation du réseau des pods.
Sous Linux, la plupart des environnements d'exécution de conteneurs utilisent la
Container Networking Interface (CNI)
pour dialoguer avec l'implémentation du réseau des pods. C'est pourquoi ces
implémentations sont souvent appelées plugins CNI.
Kubernetes fournit une implémentation par défaut du proxy de service,
appelée kube-proxy, mais certaines implémentations
du réseau des pods utilisent plutôt leur propre proxy de service,
plus étroitement intégré au reste de leur implémentation.
Les NetworkPolicies sont en général aussi mises en œuvre par l'implémentation du réseau
des pods. (Certaines implémentations plus simples du réseau des pods ne
prennent pas en charge les NetworkPolicies, ou un administrateur peut choisir de
configurer le réseau des pods sans elles. Dans
ces cas, l'API reste présente, mais elle n'a aucun effet.)
Il existe de nombreuses implémentations de Gateway API,
certaines propres à des environnements cloud particuliers, d'autres plutôt
orientées vers les environnements « bare metal », et d'autres plus génériques.
Exposez une application qui s'exécute dans votre cluster derrière un point d'accès externe unique, même lorsque la charge de travail est répartie sur plusieurs backends.
Dans Kubernetes, un Service est une manière abstraite d'exposer une application s'exécutant sur un ensemble de Pods en tant que service réseau.
L'un des buts des Services est de vous éviter de modifier votre application pour l'adapter à un
mécanisme de découverte de services qu'elle ne connaît pas.
Le code qui tourne dans vos Pods peut être une application conçue pour le cloud (cloud native) ou
une ancienne application que vous avez simplement mise en conteneur. Dans les deux cas, un Service
rend cet ensemble de Pods accessible sur le réseau, pour que des clients puissent l'utiliser.
Si votre application tourne dans un Déploiement,
celui-ci crée et détruit des Pods au fil de l'eau. À un instant donné,
vous ne savez pas combien de Pods fonctionnent correctement, ni même forcément
comment ils s'appellent.
Kubernetes crée et détruit les Pods
pour atteindre l'état souhaité de votre cluster : ce sont des ressources éphémères. Ne comptez
pas sur la fiabilité ni sur la durée de vie d'un Pod en particulier.
Chaque Pod a sa propre adresse IP (c'est au plugin réseau de le garantir).
Or, pour un même Deployment, les Pods qui font tourner l'application à un instant donné
ne sont pas forcément les mêmes un instant plus tard.
D'où un problème. Imaginons que certains Pods (les « backends ») rendent un service
à d'autres Pods (les « frontends ») de votre cluster. Comment les frontends savent-ils
à quelle adresse IP joindre un backend, alors que ces adresses peuvent changer d'un instant à l'autre ?
C'est précisément le rôle des Services.
Les Services dans Kubernetes
L'API Service de Kubernetes est une abstraction qui vous aide à exposer des groupes de
Pods sur le réseau. Chaque objet Service définit un ensemble logique de points de terminaison (le plus souvent
des Pods) et une politique qui indique comment rendre ces Pods accessibles.
Prenons un backend de traitement d'images sans état, qui tourne avec
3 réplicas. Ces 3 réplicas font exactement la même chose : peu importe à un frontend
lequel lui répond. Et si les Pods qui composent ce backend changent,
les frontends n'ont pas à le savoir ni à tenir à jour eux-mêmes
la liste des backends.
C'est ce découplage que permet l'abstraction Service.
L'ensemble des Pods ciblés par un Service est en général déterminé
par un sélecteur que vous
définissez.
Pour découvrir d'autres façons de définir les points de terminaison d'un Service,
consultez Services sans sélecteurs.
Si votre charge de travail communique en HTTP, vous pouvez utiliser un
Ingress pour contrôler la façon dont le trafic web
lui parvient.
Un Ingress n'est pas un type de Service, mais il sert de point d'entrée à votre
cluster. Il vous permet de regrouper vos règles de routage dans une seule ressource,
et donc d'exposer derrière un seul point d'écoute plusieurs composants de votre charge de travail
qui s'exécutent séparément dans le cluster.
L'API Gateway de Kubernetes
va plus loin qu'Ingress et Service. Gateway est une famille d'API d'extension, mises en œuvre avec des
CustomResourceDefinitions :
vous l'ajoutez à votre cluster, puis vous l'utilisez pour configurer l'accès aux services réseau
qui s'y exécutent.
Découverte de services cloud native
Si votre application peut utiliser les API Kubernetes pour la découverte de services,
vous pouvez interroger le serveur d'API
pour obtenir les EndpointSlices correspondants. Kubernetes met à jour les EndpointSlices d'un Service
chaque fois que l'ensemble des Pods de ce Service change.
Pour les applications qui ne s'appuient pas sur ces API, Kubernetes permet de placer un port réseau
ou un équilibreur de charge entre votre application et les Pods backend.
Dans les deux cas, votre charge de travail peut utiliser ces mécanismes de découverte de services
pour trouver la cible à laquelle elle veut se connecter.
Définir un Service
Un Service est un objet
(au même titre qu'un Pod ou une ConfigMap). Vous pouvez créer,
consulter ou modifier des définitions de Service avec l'API Kubernetes. En général,
c'est un outil comme kubectl qui fait ces appels d'API à votre place.
Par exemple, supposons que vous ayez un ensemble de Pods qui écoutent chacun sur le port TCP 9376
et qui portent le label app.kubernetes.io/name=MyApp. Vous pouvez définir un Service pour
exposer ce port TCP :
Appliquer ce manifeste crée un nouveau Service nommé « my-service », avec le
type de Service ClusterIP par défaut. Le Service
cible le port TCP 9376 de tout Pod qui porte le label app.kubernetes.io/name: MyApp.
Kubernetes attribue à ce Service une adresse IP (l'adresse IP de cluster),
utilisée par le mécanisme d'IP virtuelles. Pour plus de détails sur ce mécanisme,
lisez IP virtuelles et proxys de service.
Le contrôleur de ce Service recherche en continu les Pods qui
correspondent à son sélecteur, et met à jour au besoin les
EndpointSlices du Service.
Un Service peut associer n'importe quelport entrant à un targetPort. Par défaut, et
pour plus de simplicité, le targetPort prend la même valeur que le champ port.
Définitions de ports
Les ports définis dans les Pods ont des noms, auxquels vous pouvez faire référence dans
l'attribut targetPort d'un Service. Par exemple, on peut associer le targetPort
du Service au port du Pod de la façon suivante :
Cela fonctionne même si le Service regroupe des Pods différents qui utilisent le même
nom de port, avec le même protocole réseau mais des numéros de port
différents. Vous gagnez ainsi beaucoup de souplesse pour déployer et faire évoluer
vos Services. Par exemple, vous pouvez changer le numéro de port qu'exposent les Pods
dans la version suivante de votre logiciel backend, sans casser les clients.
Le protocole par défaut des Services est
TCP ; vous pouvez aussi
utiliser n'importe quel autre protocole pris en charge.
Comme de nombreux Services doivent exposer plusieurs ports, Kubernetes prend en charge
plusieurs définitions de ports pour un même Service.
Chaque définition de port peut utiliser le même protocol que les autres ou un protocole différent.
Services sans sélecteurs
La plupart du temps, un Service donne accès à des Pods Kubernetes grâce à son sélecteur.
Mais un Service sans sélecteur, associé aux objets
EndpointSlices correspondants,
peut aussi servir d'abstraction pour d'autres types de backends,
y compris des backends qui s'exécutent en dehors du cluster.
Par exemple :
Vous voulez utiliser un cluster de bases de données externe en production, mais vos propres
bases de données dans votre environnement de test.
Vous voulez faire pointer votre Service vers un Service d'un autre
Namespace ou d'un autre cluster.
Vous migrez une charge de travail vers Kubernetes et, pendant la phase d'évaluation,
vous n'exécutez qu'une partie de vos backends dans Kubernetes.
Dans tous ces cas, vous pouvez définir un Service sans sélecteur
de Pods. Par exemple :
Comme ce Service n'a pas de sélecteur, les objets EndpointSlice correspondants
ne sont pas créés automatiquement. Pour associer le Service
à l'adresse réseau et au port où s'exécute le backend, ajoutez vous-même un objet
EndpointSlice. Par exemple :
apiVersion:discovery.k8s.io/v1kind:EndpointSlicemetadata:name:my-service-1# by convention, use the name of the Service# as a prefix for the name of the EndpointSlicelabels:# You should set the "kubernetes.io/service-name" label.# Set its value to match the name of the Servicekubernetes.io/service-name:my-serviceaddressType:IPv4ports:- name:http# should match with the name of the service port defined aboveappProtocol:httpprotocol:TCPport:9376endpoints:- addresses:- "10.4.5.6"- addresses:- "10.1.2.3"
EndpointSlices personnalisés
Lorsque vous créez un objet EndpointSlice pour un Service, vous pouvez
lui donner n'importe quel nom. Chaque EndpointSlice d'un namespace doit avoir un
nom unique. Pour relier un EndpointSlice à un Service, posez sur cet EndpointSlice le
labelkubernetes.io/service-name.
Note:
Les adresses IP des points de terminaison ne doivent pas être des adresses de loopback (127.0.0.0/8 pour IPv4, ::1/128 pour IPv6), ni
des adresses link-local (169.254.0.0/16 et 224.0.0.0/24 pour IPv4, fe80::/64 pour IPv6).
Les adresses IP des points de terminaison ne peuvent pas être les adresses IP de cluster d'autres Services Kubernetes,
car kube-proxy ne prend pas en charge les adresses IP virtuelles
comme destination.
Pour un EndpointSlice que vous créez vous-même, ou par votre propre code,
vous devriez aussi choisir une valeur pour le label
endpointslice.kubernetes.io/managed-by.
Si vous écrivez votre propre contrôleur pour gérer les EndpointSlices, envisagez une
valeur du type "my-domain.example/name-of-controller". Si vous utilisez un outil
tiers, utilisez le nom de l'outil tout en minuscules, en remplaçant les espaces et les autres
signes de ponctuation par des tirets (-).
Si des personnes gèrent les EndpointSlices directement avec un outil comme kubectl,
utilisez un nom qui décrit cette gestion manuelle, comme "staff" ou
"cluster-admins". Évitez la valeur réservée "controller", qui identifie les EndpointSlices
gérés par le plan de contrôle de Kubernetes lui-même.
Accéder à un Service sans sélecteur
Un Service sans sélecteur s'utilise exactement comme un Service avec sélecteur.
Dans l'exemple de Service sans sélecteur,
le trafic est acheminé vers l'un des deux points de terminaison définis dans
le manifeste de l'EndpointSlice : une connexion TCP vers 10.1.2.3 ou 10.4.5.6, sur le port 9376.
Note:
Le serveur d'API Kubernetes refuse de servir de proxy vers des points de terminaison qui ne correspondent pas
à des pods. Les actions comme kubectl port-forward service/<service-name> forwardedPort:servicePort sur un Service
sans sélecteur échouent donc. Cette contrainte empêche d'utiliser le serveur d'API Kubernetes
comme proxy vers des points de terminaison auxquels l'appelant n'a peut-être pas le droit d'accéder.
Un Service ExternalName est un cas particulier : il n'a pas de
sélecteur et utilise des noms DNS à la place. Pour plus d'informations, consultez la section
ExternalName.
EndpointSlices
Feature state:Stable since Kubernetes v1.21
Les EndpointSlices sont des objets qui
représentent une partie (une tranche) des points de terminaison réseau d'un Service.
Votre cluster Kubernetes suit le nombre de points de terminaison de chaque EndpointSlice.
Quand un Service a tant de points de terminaison qu'un seuil est atteint,
Kubernetes ajoute un EndpointSlice vide et y enregistre les nouveaux points de terminaison.
Par défaut, Kubernetes crée un nouvel EndpointSlice quand tous les EndpointSlices existants
contiennent au moins 100 points de terminaison, et seulement au moment où un point de terminaison
supplémentaire doit être ajouté.
Consultez EndpointSlices pour plus
d'informations sur cette API.
Endpoints (obsolète)
Feature state:Deprecated since Kubernetes v1.33
L'API EndpointSlice est l'évolution de l'ancienne API
Endpoints.
Par rapport à EndpointSlice, l'API Endpoints, obsolète,
pose plusieurs problèmes :
Elle ne prend pas en charge les clusters en double pile.
Elle ne contient pas les informations nécessaires aux fonctionnalités plus récentes, comme
trafficDistribution.
Elle tronque la liste des points de terminaison si celle-ci est trop longue pour tenir dans un seul objet.
Il est donc recommandé à tous les clients d'utiliser
l'API EndpointSlice plutôt qu'Endpoints.
Points de terminaison en surcapacité
Kubernetes limite le nombre de points de terminaison que peut contenir un objet
Endpoints. Au-delà de 1000 points de terminaison pour un Service, Kubernetes
tronque les données de l'objet Endpoints. Comme un Service peut être relié
à plusieurs EndpointSlices, cette limite de 1000 ne
concerne que l'ancienne API Endpoints.
Dans ce cas, Kubernetes enregistre au maximum 1000 points de terminaison backend
dans l'objet Endpoints, et y pose une
annotation :
endpoints.kubernetes.io/over-capacity: truncated.
Le plan de contrôle retire aussi cette annotation lorsque le nombre de Pods backend repasse sous 1000.
Le trafic est toujours envoyé aux backends, mais tout mécanisme d'équilibrage de charge qui s'appuie sur
l'ancienne API Endpoints n'utilise au maximum que 1000 des points de terminaison disponibles.
Pour la même raison, vous ne pouvez pas mettre à jour manuellement un objet Endpoints pour lui donner plus de 1000 points de terminaison.
Protocole applicatif
Feature state:Stable since Kubernetes v1.20
Le champ appProtocol permet d'indiquer le protocole applicatif de
chaque port d'un Service. Les implémentations s'en servent comme d'une indication pour offrir
un comportement plus riche avec les protocoles qu'elles connaissent.
La valeur de ce champ est recopiée dans les objets
Endpoints et EndpointSlice correspondants.
Ce champ suit la syntaxe standard des labels Kubernetes. Les valeurs valides sont l'une des suivantes :
Certains Services doivent exposer plusieurs ports.
Kubernetes vous permet de configurer plusieurs définitions de ports sur un même objet Service.
Dans ce cas, vous devez donner un nom à chacun des ports
pour éviter toute ambiguïté.
Par exemple :
Comme pour les noms Kubernetes en général, les noms de ports
ne doivent contenir que des caractères alphanumériques en minuscules et des -. Les noms de ports doivent
aussi commencer et se terminer par un caractère alphanumérique.
Par exemple, les noms 123-abc et web sont valides, mais 123_abc et -web ne le sont pas.
Type de Service
Pour certaines parties de votre application (par exemple les frontends), vous voudrez peut-être exposer un
Service sur une adresse IP externe, accessible depuis l'extérieur de votre
cluster.
Le type d'un Service Kubernetes vous permet d'indiquer quel genre de Service vous voulez.
Voici les valeurs possibles de type et leur comportement :
Expose le Service sur une adresse IP interne au cluster : le Service n'est alors
joignable que depuis le cluster. C'est la valeur par défaut si vous n'indiquez pas
explicitement de type pour un Service.
Vous pouvez exposer le Service sur Internet avec un
Ingress ou une
Gateway.
Expose le Service sur un port statique (le NodePort) de l'adresse IP de chaque nœud.
Pour rendre ce port de nœud disponible, Kubernetes configure aussi une adresse IP de cluster,
comme pour un Service de type: ClusterIP.
Expose le Service à l'extérieur grâce à un équilibreur de charge externe. Kubernetes
ne fournit pas directement de composant d'équilibrage de charge : vous devez en fournir un,
ou intégrer votre cluster Kubernetes à un fournisseur de cloud.
Associe le Service au contenu du champ externalName (par exemple
au nom d'hôte api.foo.bar.example). Le serveur DNS de votre cluster est alors
configuré pour renvoyer un enregistrement CNAME avec ce nom d'hôte externe.
Aucun proxy, de quelque sorte que ce soit, n'est mis en place.
Le champ type de l'API Service est conçu comme une suite de fonctionnalités imbriquées : chaque niveau
s'ajoute au précédent. Il y a toutefois une exception à ce principe : vous pouvez
définir un Service LoadBalancer en
désactivant l'allocation de NodePort pour l'équilibreur de charge.
type: ClusterIP
Ce type de Service, utilisé par défaut, attribue une adresse IP prise dans un pool d'adresses
que votre cluster réserve à cet usage.
Plusieurs autres types de Service reposent sur le type ClusterIP.
Si vous définissez un Service dont .spec.clusterIP vaut "None",
Kubernetes n'attribue pas d'adresse IP. Consultez Services headless
pour plus d'informations.
Choisir votre propre adresse IP
Vous pouvez choisir vous-même l'adresse IP de cluster dans la requête de création
d'un Service, en renseignant le champ .spec.clusterIP. C'est utile par exemple si vous
avez une entrée DNS existante à réutiliser, ou d'anciens systèmes
configurés pour une adresse IP précise et difficiles à reconfigurer.
L'adresse IP que vous choisissez doit être une adresse IPv4 ou IPv6 valide, comprise dans la
plage CIDR service-cluster-ip-range configurée pour le serveur d'API.
Si vous essayez de créer un Service avec une valeur clusterIP invalide, le serveur
d'API renvoie un code d'état HTTP 422 pour signaler le problème.
Lisez Éviter les collisions
pour savoir comment Kubernetes aide à réduire le risque, et l'impact, d'une situation où deux Services
différents essaient d'utiliser la même adresse IP.
type: NodePort
Si vous donnez au champ type la valeur NodePort, le plan de contrôle de Kubernetes
alloue un port dans une plage définie par l'option --service-node-port-range (par défaut : 30000-32767).
Sur chaque nœud, ce port (le même numéro partout) est relayé vers votre Service.
Votre Service indique le port alloué dans son champ .spec.ports[*].nodePort.
Utiliser un NodePort vous laisse libre de mettre en place votre propre solution d'équilibrage de charge,
de configurer des environnements que Kubernetes ne prend pas entièrement en charge, ou même
d'exposer directement les adresses IP d'un ou plusieurs nœuds.
Pour un Service NodePort, Kubernetes alloue en plus un port (TCP, UDP ou
SCTP, selon le protocole du Service). Chaque nœud du cluster se configure
pour écouter sur ce port et transférer le trafic vers l'un des points de terminaison
prêts du Service. Depuis l'extérieur du cluster, vous pouvez joindre le Service de type: NodePort
en vous connectant à n'importe quel nœud avec le bon protocole (par exemple TCP)
et le bon port (celui attribué au Service).
Choisir votre propre port
Si vous voulez un numéro de port précis, indiquez-le dans le champ
nodePort. Le plan de contrôle vous attribuera ce port, ou signalera l'échec
de la transaction de l'API.
C'est donc à vous de gérer les éventuelles collisions de ports.
Le numéro de port doit aussi être valide, c'est-à-dire compris dans la plage configurée
pour les NodePorts.
Voici un exemple de manifeste pour un Service de type: NodePort qui indique
une valeur de NodePort (30007 dans cet exemple) :
apiVersion:v1kind:Servicemetadata:name:my-servicespec:type:NodePortselector:app.kubernetes.io/name:MyAppports:- port:80# By default and for convenience, the `targetPort` is set to# the same value as the `port` field.targetPort:80# Optional field# By default and for convenience, the Kubernetes control plane# will allocate a port from a range (default: 30000-32767)nodePort:30007
Réserver des plages de NodePort pour éviter les collisions
La politique d'attribution des ports aux Services NodePort vaut aussi bien pour l'attribution automatique
que pour l'attribution manuelle. Quand un utilisateur veut créer un Service NodePort sur
un port précis, ce port peut entrer en conflit avec un port déjà attribué.
Pour éviter ce problème, la plage de ports des Services NodePort est divisée en deux bandes.
L'attribution dynamique utilise par défaut la bande haute, et peut passer à la bande basse une fois
la bande haute épuisée. Les utilisateurs peuvent ainsi choisir leurs ports dans la bande basse, avec moins de risque de collision.
Avec la plage NodePort par défaut 30000-32767, les bandes sont réparties ainsi :
Configuration des adresses IP des Services de type: NodePort
Lorsque kube-proxy est utilisé en mode
iptables, les Services NodePort sont
disponibles par défaut sur toutes les adresses IP du nœud. En mode
nftables, ils ne sont
disponibles par défaut que sur l'adresse IP principale du nœud (ou les adresses IP principales en double pile).
Vous pouvez changer l'ensemble des adresses IP de nœud sur lesquelles les Services NodePort sont disponibles avec
l'option --nodeport-addresses de kube-proxy, ou le champ équivalent nodePortAddresses
du fichier de configuration de kube-proxy.
Elle accepte une liste de blocs d'adresses IP séparés par des virgules (par exemple 10.0.0.0/8, 192.0.2.0/25), ou un
ou plusieurs des mots-clés suivants :
primary : l'adresse IPv4 et/ou IPv6 principale du nœud, d'après l'objet Node.
(C'est la valeur par défaut en mode nftables.)
localhost : les adresses de loopback du nœud (127.0.0.0/8, ::1/128).
all : toutes les adresses. (C'est la valeur par défaut en modes iptables et ipvs.)
Par exemple, si vous démarrez kube-proxy avec l'option --nodeport-addresses=192.168.0.0/24,
kube-proxy essaie de trouver sur chaque nœud une adresse IP locale dans ce sous-réseau, et ne sert
les Services NodePort que sur cette adresse IP.
Services de type: NodePort via localhost
Les mécanismes qu'utilisent les proxys de service pour mettre en œuvre les Services NodePort ne permettent pas toujours
de les rendre disponibles sur localhost. Pour kube-proxy :
En mode iptables, avec une valeur de --nodeport-addresses qui inclut
127.0.0.1, les Services NodePort sont disponibles sur 127.0.0.1. Cela
nécessite toutefois d'activer un sysctl du noyau (route_localnet) qui peut avoir des effets secondaires
néfastes pour la sécurité dans certains clusters. Pour désactiver les NodePorts sur localhost en mode iptables, passez
--iptables-localhost-nodeports false à kube-proxy, ou donnez à
--nodeport-addresses une plage qui n'inclut pas 127.0.0.1.
En mode ipvs, ou en mode iptables dans un cluster IPv6 en pile simple, les Services
NodePort ne sont pas disponibles sur localhost.
Feature state:Alpha since Kubernetes v1.37; disabled by default
More information about this feature
To use this feature, you (or a cluster administrator) will need to enable the KubeProxyNFTablesLocalhostNodePorts feature gate for all relevant components in your cluster.
En mode nftables, les Services NodePort sont disponibles sur localhost lorsque la
feature gate KubeProxyNFTablesLocalhostNodePorts est activée et que
--nodeport-addresses a une valeur qui inclut explicitement localhost.
(La valeur all seule ne suffit pas.) Cette fonctionnalité redirige
les connexions NodePort sur localhost vers un proxy en espace utilisateur :
elle est donc moins efficace que le proxy de service habituel.
Les plugins réseau tiers qui ont leur propre implémentation de proxy de service peuvent prendre en charge
ou non les NodePorts localhost : consultez la documentation de ces plugins.
type: LoadBalancer
Chez les fournisseurs de cloud qui proposent des équilibreurs de charge externes, la valeur
LoadBalancer du champ type provisionne un équilibreur de charge pour votre Service.
L'équilibreur de charge est créé de façon asynchrone, et
les informations le concernant sont publiées dans le champ
.status.loadBalancer du Service.
Par exemple :
Le trafic de l'équilibreur de charge externe est dirigé vers les Pods backend. C'est le fournisseur de
cloud qui décide comment répartir la charge.
Pour mettre en œuvre un Service de type: LoadBalancer, Kubernetes commence en général
par faire les mêmes changements que si vous aviez demandé un Service de
type: NodePort. Le composant cloud-controller-manager configure ensuite l'équilibreur de charge
externe pour qu'il transfère le trafic vers le port de nœud attribué.
Vous pouvez configurer un Service avec équilibreur de charge pour
ne pas lui attribuer de port de nœud, à condition que
l'implémentation du fournisseur de cloud le permette.
Certains fournisseurs de cloud vous permettent d'indiquer le loadBalancerIP. Dans ce cas, l'équilibreur de charge est créé
avec le loadBalancerIP indiqué par l'utilisateur. Si le champ loadBalancerIP n'est pas renseigné,
l'équilibreur de charge est configuré avec une adresse IP éphémère. Si vous indiquez un loadBalancerIP
mais que votre fournisseur de cloud ne prend pas en charge cette fonctionnalité, le champ loadbalancerIP que vous
avez défini est ignoré.
Note:
Le champ .spec.loadBalancerIP d'un Service est obsolète depuis Kubernetes v1.24.
Ce champ était insuffisamment spécifié et son sens varie selon les implémentations.
Il ne peut pas non plus prendre en charge le réseau en double pile. Ce champ pourrait être supprimé dans une future version de l'API.
Si votre fournisseur permet d'indiquer la ou les adresses IP de l'équilibreur de charge
d'un Service par une annotation (qui lui est propre), vous devriez passer à cette méthode.
Si vous écrivez du code pour intégrer un équilibreur de charge à Kubernetes, évitez d'utiliser ce champ.
Vous pouvez vous appuyer sur Gateway plutôt que sur Service, ou
définir sur le Service vos propres annotations (propres au fournisseur) qui portent l'information équivalente.
Impact de la disponibilité des nœuds sur le trafic de l'équilibreur de charge
Les vérifications de santé des équilibreurs de charge sont essentielles aux applications modernes. Elles permettent de
déterminer vers quel serveur (machine virtuelle ou adresse IP) l'équilibreur de charge doit
envoyer le trafic. Les API Kubernetes ne définissent pas comment mettre en œuvre ces vérifications
pour les équilibreurs de charge gérés par Kubernetes : ce sont les fournisseurs de cloud
(et les personnes qui écrivent le code d'intégration) qui décident du comportement. Ces vérifications de santé
sont très utilisées pour prendre en charge le champ
externalTrafficPolicy des Services.
Équilibreurs de charge avec plusieurs protocoles
This is a stable feature in Kubernetes, and has been since the 1.26 release. You can no longer toggle this feature (the associated feature gate has been removed).
Par défaut, pour les Services de type LoadBalancer qui définissent plusieurs ports, tous
les ports doivent avoir le même protocole, et ce protocole doit être pris en charge
par le fournisseur de cloud.
La feature gate MixedProtocolLBService (activée par défaut pour kube-apiserver depuis la v1.24) permet d'utiliser
des protocoles différents pour les Services de type LoadBalancer qui définissent plusieurs ports.
Note:
C'est votre fournisseur de cloud qui définit les protocoles utilisables pour les Services avec équilibreur
de charge, et il peut imposer des restrictions plus strictes que l'API Kubernetes.
Désactiver l'allocation de NodePort pour l'équilibreur de charge
Feature state:Stable since Kubernetes v1.24
Vous pouvez, si vous le souhaitez, désactiver l'allocation de ports de nœud pour un Service de type: LoadBalancer en donnant
au champ spec.allocateLoadBalancerNodePorts la valeur false. Ne l'utilisez que pour les implémentations d'équilibreur de charge
qui acheminent le trafic directement vers les pods, sans passer par des ports de nœud. Par défaut, spec.allocateLoadBalancerNodePorts
vaut true, et les Services de type LoadBalancer continuent d'allouer des ports de nœud. Si vous passez spec.allocateLoadBalancerNodePorts
à false sur un Service existant qui a déjà des ports de nœud alloués, ces ports ne sont pas libérés automatiquement.
Pour les libérer, vous devez supprimer explicitement l'entrée nodePorts de chaque port du Service.
Indiquer la classe d'implémentation de l'équilibreur de charge
Feature state:Stable since Kubernetes v1.24
Pour un Service dont le type vaut LoadBalancer, le champ .spec.loadBalancerClass
vous permet d'utiliser une autre implémentation d'équilibreur de charge que celle fournie par défaut par le fournisseur de cloud.
Par défaut, .spec.loadBalancerClass n'est pas défini, et un Service de type
LoadBalancer utilise l'implémentation d'équilibreur de charge par défaut du fournisseur de cloud si le
cluster est configuré avec un fournisseur de cloud via l'option --cloud-provider de ses
composants.
Si vous indiquez .spec.loadBalancerClass, Kubernetes considère qu'une implémentation d'équilibreur
de charge correspondant à cette classe surveille les Services.
Toute implémentation d'équilibreur de charge par défaut (par exemple celle du
fournisseur de cloud) ignore les Services pour lesquels ce champ est défini.
spec.loadBalancerClass ne peut être défini que sur un Service de type LoadBalancer.
Une fois défini, il ne peut plus être modifié.
La valeur de spec.loadBalancerClass doit être un identifiant au format d'un label,
avec un préfixe facultatif, comme « internal-vip » ou « example.com/internal-vip ».
Les noms sans préfixe sont réservés aux utilisateurs finaux.
Mode d'adresse IP de l'équilibreur de charge
Pour un Service de type: LoadBalancer, un contrôleur peut définir .status.loadBalancer.ingress.ipMode.
Le champ .status.loadBalancer.ingress.ipMode indique le comportement de l'adresse IP de l'équilibreur de charge.
Il ne peut être indiqué que si le champ .status.loadBalancer.ingress.ip l'est aussi.
.status.loadBalancer.ingress.ipMode peut prendre deux valeurs : « VIP » et « Proxy ».
La valeur par défaut, « VIP », signifie que le trafic arrive au nœud
avec pour destination l'adresse IP et le port de l'équilibreur de charge.
Avec « Proxy », deux cas sont possibles, selon la façon dont l'équilibreur de charge
du fournisseur de cloud achemine le trafic :
Si le trafic arrive au nœud puis est traduit (DNAT) vers le pod, la destination est l'adresse IP et le port de nœud ;
Si le trafic arrive directement au pod, la destination est l'adresse IP et le port du pod.
Les implémentations de Service peuvent utiliser cette information pour ajuster le routage du trafic.
Équilibreur de charge interne
Dans un environnement mixte, il est parfois nécessaire d'acheminer le trafic de Services situés dans le même
bloc d'adresses réseau (virtuel).
Dans un environnement DNS split-horizon, il vous faudrait deux Services pour acheminer à la fois le trafic externe
et le trafic interne vers vos points de terminaison.
Pour configurer un équilibreur de charge interne, ajoutez à votre Service l'une des annotations suivantes,
selon le fournisseur de cloud que vous utilisez :
Un Service de type ExternalName est associé à un nom DNS, et non à un sélecteur classique comme
my-service ou cassandra. Vous indiquez ce nom avec le paramètre spec.externalName.
Par exemple, cette définition associe
le Service my-service du namespace prod à my.database.example.com :
Un Service de type: ExternalName accepte une adresse IPv4 sous forme de chaîne,
mais il la traite comme un nom DNS composé de chiffres,
et non comme une adresse IP (Internet n'autorise d'ailleurs pas ce genre de noms dans le DNS).
Les serveurs DNS ne résolvent pas les Services dont le nom externe ressemble
à une adresse IPv4.
Pour associer un Service directement à une adresse IP précise, envisagez plutôt
des Services headless.
Quand on recherche l'hôte my-service.prod.svc.cluster.local, le Service DNS du cluster
renvoie un enregistrement CNAME de valeur my.database.example.com. On accède à
my-service comme aux autres Services, à une différence près, essentielle :
la redirection se fait au niveau du DNS, et non par un proxy ou un
transfert. Si vous décidez plus tard d'intégrer votre base de données au cluster, vous
pourrez démarrer ses Pods, ajouter les sélecteurs ou les points de terminaison nécessaires, et changer le
type du Service.
Avertissement:
ExternalName peut poser problème avec certains protocoles courants, dont HTTP et HTTPS.
En effet, le nom d'hôte qu'utilisent les clients de votre cluster n'est pas le même
que le nom auquel l'ExternalName fait référence.
Pour les protocoles qui utilisent des noms d'hôte, cette différence peut entraîner des erreurs ou des réponses inattendues.
Les requêtes HTTP auront un en-tête Host: que le serveur d'origine ne reconnaît pas ;
les serveurs TLS ne pourront pas fournir de certificat correspondant au nom d'hôte auquel le client s'est connecté.
Services headless
Parfois, vous n'avez besoin ni d'équilibrage de charge ni d'une adresse IP unique pour le Service. Dans
ce cas, vous pouvez créer ce qu'on appelle des Services headless, en indiquant explicitement
"None" comme adresse IP de cluster (.spec.clusterIP).
Un Service headless vous permet de vous interfacer avec d'autres mécanismes de découverte de services,
sans dépendre de l'implémentation de Kubernetes.
Pour les Services headless, aucune adresse IP de cluster n'est allouée, kube-proxy ne gère pas
ces Services, et la plateforme ne fait pour eux ni équilibrage de charge ni proxy.
Un Service headless permet à un client de se connecter directement au Pod de son choix. Ces Services ne
configurent ni routes ni transfert de paquets à l'aide
d'adresses IP virtuelles et de proxys : ils publient à la place les
adresses IP de chaque pod via des enregistrements DNS internes, servis par le
service DNS du cluster.
Pour définir un Service headless, créez un Service dont .spec.type vaut ClusterIP (la valeur par défaut de type),
et donnez en plus à .spec.clusterIP la valeur None.
La chaîne None est un cas particulier : ce n'est pas la même chose que de laisser le champ .spec.clusterIP vide.
La configuration automatique du DNS dépend de la présence ou non de sélecteurs sur le Service :
Avec sélecteurs
Pour les Services headless qui définissent des sélecteurs, le contrôleur des points de terminaison crée
des EndpointSlices dans l'API Kubernetes et modifie la configuration DNS pour qu'elle renvoie
des enregistrements A ou AAAA (adresses IPv4 ou IPv6) qui pointent directement vers les Pods du Service.
Sans sélecteurs
Pour les Services headless qui ne définissent pas de sélecteurs, le plan de contrôle ne
crée pas d'objets EndpointSlice. Le système DNS recherche et configure toutefois,
selon le cas :
des enregistrements DNS A / AAAA pour toutes les adresses IP des points de terminaison prêts du Service,
pour tous les types de Service autres que ExternalName.
Pour les points de terminaison IPv4, le système DNS crée des enregistrements A.
Pour les points de terminaison IPv6, le système DNS crée des enregistrements AAAA.
Lorsque vous définissez un Service headless sans sélecteur, le port doit
être identique au targetPort.
Découvrir les services
Pour les clients qui s'exécutent dans votre cluster, Kubernetes propose deux méthodes principales pour
trouver un Service : les variables d'environnement et le DNS.
Variables d'environnement
Lorsqu'un Pod s'exécute sur un nœud, le kubelet ajoute un ensemble de variables d'environnement
pour chaque Service actif. Il ajoute les variables {SVCNAME}_SERVICE_HOST et {SVCNAME}_SERVICE_PORT,
où le nom du Service est mis en majuscules et les tirets sont remplacés par des tirets bas.
Par exemple, le Service redis-primary, qui expose le port TCP 6379 et a reçu
l'adresse IP de cluster 10.0.0.11, produit les variables d'environnement
suivantes :
Si un Pod doit accéder à un Service et que vous transmettez
le port et l'adresse IP de cluster aux Pods clients par des variables d'environnement,
vous devez créer le Service avant les Pods clients.
Sinon, les variables d'environnement de ces Pods ne seront pas renseignées.
Si vous passez uniquement par le DNS pour trouver l'adresse IP de cluster d'un Service, cette question
d'ordre ne se pose pas.
Kubernetes fournit aussi des variables compatibles avec la fonctionnalité
« legacy container links » de Docker Engine.
Pour voir comment c'est mis en œuvre dans Kubernetes, lisez
makeLinkVariables.
DNS
Vous pouvez (et devriez presque toujours) installer un service DNS dans votre cluster
Kubernetes avec un module complémentaire.
Un serveur DNS qui connaît le cluster, comme CoreDNS, surveille l'API Kubernetes pour repérer les nouveaux
Services et crée un ensemble d'enregistrements DNS pour chacun. Si le DNS est activé
dans tout le cluster, tous les Pods devraient pouvoir résoudre automatiquement
les Services par leur nom DNS.
Par exemple, si vous avez un Service appelé my-service dans un namespace
Kubernetes my-ns, le plan de contrôle et le Service DNS créent ensemble
un enregistrement DNS pour my-service.my-ns. Les Pods du namespace my-ns
devraient trouver le Service en résolvant simplement le nom my-service
(my-service.my-ns fonctionne aussi).
Les Pods des autres namespaces doivent utiliser le nom qualifié my-service.my-ns. Ces noms
sont résolus en l'adresse IP de cluster du Service.
Kubernetes prend aussi en charge les enregistrements DNS SRV (Service) pour les ports nommés. Si le
Service my-service.my-ns a un port nommé http dont le protocole est
TCP, vous pouvez faire une requête DNS SRV sur _http._tcp.my-service.my-ns pour obtenir
le numéro de port de http, ainsi que l'adresse IP.
Les Services ExternalName ne sont accessibles que par le serveur DNS de Kubernetes.
Pour en savoir plus sur la résolution des ExternalName, consultez
DNS pour les Services et les Pods.
La page IP virtuelles et proxys de service explique le
mécanisme que Kubernetes fournit pour exposer un Service avec une adresse IP virtuelle.
Politiques de trafic
Vous pouvez définir les champs .spec.internalTrafficPolicy et .spec.externalTrafficPolicy
pour contrôler la façon dont Kubernetes achemine le trafic vers les backends en bonne santé (« ready »).
Le champ .spec.trafficDistribution est un autre moyen d'influencer le routage
du trafic dans un Service Kubernetes. Les politiques de trafic apportent des garanties
sémantiques strictes ; la distribution du trafic, elle, vous permet d'exprimer des préférences
(par exemple acheminer le trafic vers les points de terminaison les plus proches dans la topologie). Cela peut aider à optimiser
les performances, les coûts ou la fiabilité. Dans Kubernetes 1.37, les
valeurs suivantes sont prises en charge :
PreferSameZone
Indique une préférence pour acheminer le trafic vers des points de terminaison situés dans la même
zone que le client.
PreferSameNode
Indique une préférence pour acheminer le trafic vers des points de terminaison situés sur le même
nœud que le client.
PreferClose (obsolète)
Ancien alias de PreferSameZone, au sens moins
explicite.
Si le champ n'est pas défini, l'implémentation applique sa stratégie de routage par défaut.
Si vous voulez vous assurer que les connexions d'un client donné arrivent toujours au
même Pod, vous pouvez configurer une affinité de session basée sur l'adresse IP
du client. Lisez affinité de session
pour en savoir plus.
Adresses IP externes
Feature state:Deprecated since Kubernetes v1.36
Tous les utilisateurs devraient commencer à migrer pour ne plus utiliser externalIPs.
Envisagez plutôt un contrôleur d'équilibreur de charge externe ou une implémentation
de Gateway API.
Si des adresses IP externes sont routées vers un ou plusieurs nœuds du cluster, les Services Kubernetes
peuvent être exposés sur ces externalIPs. Quand du trafic réseau arrive dans le cluster avec
l'adresse IP externe pour destination et le port de ce Service, les règles et les routes
configurées par Kubernetes garantissent qu'il est acheminé vers l'un des points de terminaison
de ce Service.
Vous pouvez indiquer des externalIPs pour n'importe quel
type de Service.
Dans l'exemple ci-dessous, les clients peuvent joindre le Service "my-service" en TCP
sur "198.51.100.32:80" (calculé à partir de .spec.externalIPs[] et .spec.ports[].port).
Rendez votre service réseau HTTP (ou HTTPS) accessible grâce à un mécanisme de configuration sensible au protocole et comprend les concepts du web comme les URI, les noms d'hôte, les chemins, etc. Le concept d'Ingress vous permet d'acheminer le trafic vers différents backends selon des règles que vous définissez via l'API Kubernetes.
Feature state:Stable since Kubernetes v1.19
Un objet API qui gère l'accès externe aux services d'un cluster, typiquement HTTP.
L'Ingress peut fournir un équilibrage de charge, une terminaison SSL ainsi qu'un hébergement virtuel basé sur un nom.
Note:
Le projet Kubernetes recommande d'utiliser Gateway plutôt
qu'Ingress.
L'API Ingress est figée.
Cela signifie que :
L'API Ingress est en disponibilité générale (GA) et soumise aux garanties de stabilité prévues pour les API GA.
Le projet Kubernetes n'a pas l'intention de retirer Ingress de Kubernetes.
L'API Ingress n'est plus développée et ne recevra plus aucune modification
ni mise à jour.
Terminologie
Par souci de clarté, ce guide définit les termes suivants :
Nœud (Node) : une machine de travail de Kubernetes, qui fait partie d'un cluster.
Cluster : un ensemble de nœuds qui exécutent des applications conteneurisées gérées par Kubernetes.
Dans cet exemple, comme dans la plupart des déploiements Kubernetes courants, les nœuds du cluster
ne sont pas exposés sur l'Internet public.
Routeur de bordure (edge router) : un routeur qui applique la politique de pare-feu de votre cluster.
Il peut s'agir d'une passerelle gérée par un fournisseur de cloud ou d'un équipement physique.
Réseau du cluster : un ensemble de liens, logiques ou physiques, qui permettent la communication
au sein d'un cluster selon le modèle réseau de Kubernetes.
Service : un Service Kubernetes qui identifie
un ensemble de Pods à l'aide de sélecteurs de labels.
Sauf mention contraire, on suppose que les Services ont des adresses IP virtuelles routables uniquement dans le réseau du cluster.
Qu'est-ce qu'un Ingress ?
Un Ingress
expose des routes HTTP et HTTPS depuis l'extérieur du cluster vers des
services du cluster.
Le routage du trafic est contrôlé par des règles définies sur la ressource Ingress.
Voici un exemple simple dans lequel un Ingress envoie tout son trafic vers un seul Service :
Figure. Ingress
Un Ingress peut être configuré pour donner aux Services des URL accessibles de l'extérieur,
équilibrer la charge du trafic, assurer la terminaison SSL / TLS et proposer un hébergement virtuel basé sur le nom.
Un contrôleur d'Ingress
est chargé de mettre en œuvre l'Ingress, généralement avec un équilibreur de charge (load balancer),
mais il peut aussi configurer votre routeur de bordure ou des frontaux supplémentaires pour aider à gérer le trafic.
Un Ingress n'expose pas de ports ni de protocoles arbitraires. Pour exposer à Internet des services autres que HTTP et HTTPS,
on utilise généralement un Service de type Service.Type=NodePort ou
Service.Type=LoadBalancer.
Prérequis
Vous devez disposer d'un contrôleur d'Ingress
pour qu'un Ingress soit pris en compte. La simple création d'une ressource Ingress n'a aucun effet.
Idéalement, tous les contrôleurs d'Ingress devraient respecter la spécification de référence. En pratique,
les différents contrôleurs d'Ingress fonctionnent de manière légèrement différente.
Note:
Consultez bien la documentation de votre contrôleur d'Ingress pour connaître les limites à prendre en compte avant de le choisir.
Un Ingress a besoin des champs apiVersion, kind, metadata et spec.
Le nom d'un objet Ingress doit être un
nom de sous-domaine DNS valide.
Pour des informations générales sur l'utilisation des fichiers de configuration, consultez
déployer des applications,
configurer des conteneurs et
gérer des ressources.
Les contrôleurs d'Ingress utilisent souvent des annotations pour configurer leur comportement.
Consultez la documentation du contrôleur d'Ingress que vous avez choisi pour savoir quelles annotations sont attendues ou prises en charge.
La spec de l'Ingress
contient toutes les informations nécessaires pour configurer un équilibreur de charge ou un serveur proxy. Elle contient
surtout une liste de règles comparées à toutes les requêtes entrantes. La ressource Ingress ne prend en charge
que des règles pour diriger du trafic HTTP(S).
Certains contrôleurs d'Ingress fonctionnent même sans définition
d'une IngressClass par défaut. Même si vous utilisez un contrôleur d'Ingress capable
de fonctionner sans IngressClass, le projet Kubernetes recommande tout de même
de définir une IngressClass par défaut.
Règles d'Ingress
Chaque règle HTTP contient les informations suivantes :
Un hôte facultatif. Dans cet exemple, aucun hôte n'est indiqué : la règle s'applique donc à tout
le trafic HTTP entrant par l'adresse IP indiquée. Si un hôte est fourni (par exemple
foo.bar.com), les règles s'appliquent à cet hôte.
Une liste de chemins (par exemple /testpath), chacun associé à un
backend défini par un service.name et un service.port.name ou un
service.port.number. L'hôte et le chemin doivent tous deux correspondre au contenu
d'une requête entrante pour que l'équilibreur de charge dirige le trafic vers le
Service référencé.
Un backend est une combinaison d'un nom de Service et d'un port, comme décrit dans la
documentation des Services, ou un backend de ressource personnalisée
défini au moyen d'une CRD. Les requêtes HTTP (et HTTPS) adressées à
l'Ingress qui correspondent à l'hôte et au chemin de la règle sont envoyées au backend indiqué.
Un defaultBackend est souvent configuré dans un contrôleur d'Ingress pour traiter toutes les requêtes
qui ne correspondent à aucun chemin de la spec.
DefaultBackend
Un Ingress sans règles envoie tout le trafic vers un unique backend par défaut, et .spec.defaultBackend
est le backend qui doit traiter les requêtes dans ce cas.
Le defaultBackend est habituellement une option de configuration du
contrôleur d'Ingress et
n'est pas indiqué dans vos ressources Ingress.
Si .spec.rules n'est pas défini, .spec.defaultBackend doit l'être.
Si defaultBackend n'est pas défini, c'est le contrôleur d'Ingress qui décide du traitement des requêtes
qui ne correspondent à aucune règle (consultez la documentation de votre contrôleur d'Ingress pour savoir comment il gère ce cas).
Si aucun des hôtes ou chemins des objets Ingress ne correspond à la requête HTTP, le trafic est
acheminé vers votre backend par défaut.
Backends de ressource
Un backend Resource est une référence (ObjectRef) vers une autre ressource Kubernetes du
même namespace que l'objet Ingress. Resource et Service s'excluent mutuellement :
la validation échoue si les deux sont indiqués. Un backend Resource sert
couramment à faire entrer des données dans un backend de stockage objet
contenant des ressources statiques.
Chaque chemin d'un Ingress doit avoir un type de chemin correspondant. Les chemins
sans pathType explicite échouent à la validation. Trois types de chemins
sont pris en charge :
ImplementationSpecific : avec ce type de chemin, la correspondance dépend de
l'IngressClass. Les implémentations peuvent le traiter comme un pathType distinct ou
de la même manière que les types de chemins Prefix ou Exact.
Exact : correspond exactement au chemin de l'URL, en tenant compte de la casse.
Prefix : correspond selon un préfixe du chemin de l'URL découpé par /. La correspondance
tient compte de la casse et se fait élément par élément. Un élément de chemin désigne
la liste des libellés du chemin découpé par le séparateur /. Une requête correspond
au chemin p si chaque p est un préfixe, élément par élément, de p dans le
chemin de la requête.
Note:
Si le dernier élément du chemin est une sous-chaîne du dernier
élément du chemin de la requête, il n'y a pas de correspondance (par exemple, /foo/bar
correspond à /foo/bar/baz, mais pas à /foo/barbaz).
Exemples
Type
Chemin(s)
Chemin(s) de la requête
Correspondance ?
Prefix
/
(tous les chemins)
Oui
Exact
/foo
/foo
Oui
Exact
/foo
/bar
Non
Exact
/foo
/foo/
Non
Exact
/foo/
/foo
Non
Prefix
/foo
/foo, /foo/
Oui
Prefix
/foo/
/foo, /foo/
Oui
Prefix
/aaa/bb
/aaa/bbb
Non
Prefix
/aaa/bbb
/aaa/bbb
Oui
Prefix
/aaa/bbb/
/aaa/bbb
Oui, ignore la barre oblique finale
Prefix
/aaa/bbb
/aaa/bbb/
Oui, correspond avec la barre oblique finale
Prefix
/aaa/bbb
/aaa/bbb/ccc
Oui, correspond au sous-chemin
Prefix
/aaa/bbb
/aaa/bbbxyz
Non, ne correspond pas au préfixe de chaîne
Prefix
/, /aaa
/aaa/ccc
Oui, correspond au préfixe /aaa
Prefix
/, /aaa, /aaa/bbb
/aaa/bbb
Oui, correspond au préfixe /aaa/bbb
Prefix
/, /aaa, /aaa/bbb
/ccc
Oui, correspond au préfixe /
Prefix
/aaa
/ccc
Non, utilise le backend par défaut
Mixte
/foo (Prefix), /foo (Exact)
/foo
Oui, préfère Exact
Correspondances multiples
Dans certains cas, plusieurs chemins d'un Ingress correspondent à une requête. La priorité
est alors donnée au chemin correspondant le plus long. Si deux chemins
correspondent toujours à égalité, la priorité est donnée aux chemins de type exact
plutôt qu'aux chemins de type préfixe.
Jokers dans les noms d'hôte
Les hôtes peuvent être des correspondances précises (par exemple « foo.bar.com ») ou un joker (par
exemple « *.foo.com »). Une correspondance précise exige que l'en-tête HTTP host
corresponde au champ host. Une correspondance avec joker exige que l'en-tête HTTP host
soit égal au suffixe de la règle avec joker.
Hôte
En-tête Host
Correspondance ?
*.foo.com
bar.foo.com
Correspond grâce au suffixe commun
*.foo.com
baz.bar.foo.com
Pas de correspondance, le joker ne couvre qu'un seul libellé DNS
*.foo.com
foo.com
Pas de correspondance, le joker ne couvre qu'un seul libellé DNS
Les Ingress peuvent être mis en œuvre par différents contrôleurs, souvent avec des
configurations différentes. Chaque Ingress devrait indiquer une classe, c'est-à-dire une référence à une
ressource IngressClass qui contient une configuration supplémentaire, dont le nom
du contrôleur chargé de mettre en œuvre la classe.
Le champ .spec.parameters d'une IngressClass vous permet de référencer une autre
ressource qui fournit la configuration associée à cette IngressClass.
Le type précis de paramètres à utiliser dépend du contrôleur d'Ingress
que vous indiquez dans le champ .spec.controller de l'IngressClass.
Portée d'une IngressClass
Selon votre contrôleur d'Ingress, vous pourrez peut-être utiliser des paramètres
définis pour tout le cluster, ou pour un seul namespace.
Par défaut, les paramètres d'une IngressClass ont une portée à l'échelle du cluster.
Si vous définissez le champ .spec.parameters sans définir
.spec.parameters.scope, ou si vous définissez .spec.parameters.scope sur
Cluster, l'IngressClass fait référence à une ressource à portée cluster.
Le kind (combiné à l'apiGroup) des paramètres
fait référence à une API à portée cluster (éventuellement une ressource personnalisée), et
le name des paramètres identifie une ressource précise à portée cluster
de cette API.
Par exemple :
---apiVersion:networking.k8s.io/v1kind:IngressClassmetadata:name:external-lb-1spec:controller:example.com/ingress-controllerparameters:# The parameters for this IngressClass are specified in a# ClusterIngressParameter (API group k8s.example.net) named# "external-config-1". This definition tells Kubernetes to# look for a cluster-scoped parameter resource.scope:ClusterapiGroup:k8s.example.netkind:ClusterIngressParametername:external-config-1
Feature state:Stable since Kubernetes v1.23
Si vous définissez le champ .spec.parameters et définissez
.spec.parameters.scope sur Namespace, l'IngressClass fait référence
à une ressource à portée namespace. Vous devez aussi définir le champ namespace
de .spec.parameters avec le namespace qui contient
les paramètres que vous voulez utiliser.
Le kind (combiné à l'apiGroup) des paramètres
fait référence à une API à portée namespace (par exemple : ConfigMap), et
le name des paramètres identifie une ressource précise
dans le namespace indiqué dans namespace.
Les paramètres à portée namespace aident l'opérateur du cluster à déléguer le contrôle de la
configuration (par exemple : réglages de l'équilibreur de charge, définition de la passerelle d'API)
utilisée pour une charge de travail. Avec un paramètre à portée cluster, soit :
l'équipe qui exploite le cluster doit approuver les modifications d'une autre équipe
chaque fois qu'un nouveau changement de configuration est appliqué ;
l'équipe qui exploite le cluster doit définir des contrôles d'accès spécifiques, comme des
rôles et des liaisons RBAC, qui permettent
à l'équipe applicative de modifier la ressource de paramètres à portée cluster.
L'API IngressClass elle-même a toujours une portée cluster.
Voici un exemple d'IngressClass qui fait référence à des paramètres
à portée namespace :
---apiVersion:networking.k8s.io/v1kind:IngressClassmetadata:name:external-lb-2spec:controller:example.com/ingress-controllerparameters:# The parameters for this IngressClass are specified in an# IngressParameter (API group k8s.example.com) named "external-config",# that's in the "external-configuration" namespace.scope:NamespaceapiGroup:k8s.example.comkind:IngressParameternamespace:external-configurationname:external-config
Annotation obsolète
Avant l'ajout de la ressource IngressClass et du champ ingressClassName dans
Kubernetes 1.18, les classes d'Ingress étaient indiquées par une annotation
kubernetes.io/ingress.class sur l'Ingress. Cette annotation n'a jamais été
définie formellement, mais elle était largement prise en charge par les contrôleurs d'Ingress.
Le champ ingressClassName, plus récent, remplace cette
annotation, sans en être un équivalent direct. Alors que l'annotation servait
généralement à référencer le nom du contrôleur d'Ingress chargé de mettre en œuvre
l'Ingress, le champ est une référence à une ressource IngressClass qui contient
une configuration d'Ingress supplémentaire, dont le nom du contrôleur d'Ingress.
IngressClass par défaut
Vous pouvez marquer une IngressClass donnée comme classe par défaut de votre cluster. Définir
l'annotation ingressclass.kubernetes.io/is-default-class sur true sur une
ressource IngressClass garantit que cette IngressClass par défaut sera attribuée
aux nouveaux Ingress qui n'indiquent pas de champ ingressClassName.
Avertissement:
Si plusieurs IngressClass sont marquées comme classe par défaut de votre cluster,
le contrôleur d'admission empêche la création de nouveaux objets Ingress qui n'indiquent pas
d'ingressClassName. Pour résoudre ce problème, assurez-vous qu'au plus une
IngressClass est marquée comme classe par défaut dans votre cluster.
Commencez par définir une
IngressClass par défaut. Il est toutefois recommandé d'indiquer l'IngressClass
par défaut :
Il existe déjà des concepts Kubernetes qui permettent d'exposer un seul Service
(voir les alternatives). Vous pouvez aussi le faire avec un Ingress en indiquant un
backend par défaut sans règles.
Si vous le créez avec kubectl apply -f, vous devriez pouvoir afficher l'état
de l'Ingress que vous avez ajouté :
kubectl get ingress test-ingress
NAME           CLASS         HOSTS   ADDRESS         PORTS   AGE
test-ingress   external-lb   *       203.0.113.123   80      59s
203.0.113.123 est l'adresse IP allouée par le contrôleur d'Ingress pour satisfaire
cet Ingress.
Note:
Les contrôleurs d'Ingress et les équilibreurs de charge peuvent mettre une minute ou deux à allouer une adresse IP.
En attendant, l'adresse s'affiche souvent sous la forme <pending>.
Fanout simple
Une configuration en fanout achemine le trafic d'une seule adresse IP vers plusieurs Services,
en fonction de l'URI HTTP demandée. Un Ingress vous permet de réduire au minimum le nombre
d'équilibreurs de charge. Prenons par exemple la configuration suivante :
Name:             simple-fanout-example
Namespace:        default
Address:          178.91.123.132
Default backend:  default-http-backend:80 (10.8.2.3:8080)
Rules:
  Host         Path  Backends
  ----         ----  --------
  foo.bar.com
               /foo   service1:4200 (10.8.0.90:4200)
               /bar   service2:8080 (10.8.0.91:8080)
Events:
  Type     Reason  Age                From                     Message
  ----     ------  ----               ----                     -------
  Normal   ADD     22s                loadbalancer-controller  default/test
Le contrôleur d'Ingress provisionne un équilibreur de charge propre à son implémentation
qui satisfait l'Ingress, à condition que les Services (service1, service2) existent.
Une fois que c'est fait, vous pouvez voir l'adresse de l'équilibreur de charge dans le
champ Address.
Note:
Selon le contrôleur d'Ingress
que vous utilisez, vous devrez peut-être créer un
Service default-http-backend.
Hébergement virtuel basé sur le nom
Les hôtes virtuels basés sur le nom permettent d'acheminer le trafic HTTP vers plusieurs noms d'hôte partageant la même adresse IP.
Figure. Hébergement virtuel basé sur le nom
L'Ingress suivant indique à l'équilibreur de charge sous-jacent d'acheminer les requêtes en fonction de
l'en-tête Host.
Si vous créez une ressource Ingress sans définir d'hôte dans les règles, tout
trafic web adressé à l'adresse IP de votre contrôleur d'Ingress peut correspondre sans qu'un hôte virtuel
basé sur le nom soit nécessaire.
Par exemple, l'Ingress suivant achemine le trafic
demandé pour first.bar.com vers service1, celui pour second.bar.com vers service2,
et tout trafic dont l'en-tête Host de la requête ne correspond ni à first.bar.com
ni à second.bar.com vers service3.
Vous pouvez sécuriser un Ingress en indiquant un Secret
qui contient une clé privée et un certificat TLS. La ressource Ingress ne prend en charge
qu'un seul port TLS, le 443, et suppose que la terminaison TLS se fait au point d'entrée
(le trafic vers le Service et ses Pods circule en clair).
Si la section de configuration TLS d'un Ingress indique plusieurs hôtes, ils sont
multiplexés sur le même port selon le nom d'hôte indiqué via
l'extension TLS SNI (à condition que le contrôleur d'Ingress prenne en charge SNI). Le Secret TLS
doit contenir des clés nommées tls.crt et tls.key, qui contiennent le certificat
et la clé privée à utiliser pour TLS. Par exemple :
Référencer ce Secret dans un Ingress indique au contrôleur d'Ingress de
sécuriser avec TLS le canal entre le client et l'équilibreur de charge. Vous devez vous
assurer que le Secret TLS que vous avez créé provient d'un certificat contenant un Common
Name (CN), aussi appelé nom de domaine complet (FQDN), pour https-example.foo.com.
Note:
Gardez à l'esprit que TLS ne fonctionnera pas sur la règle par défaut, car les
certificats devraient être émis pour tous les sous-domaines possibles. C'est pourquoi
les hosts de la section tls doivent correspondre explicitement au host de la section
rules.
Les fonctionnalités TLS prises en charge varient d'un contrôleur d'Ingress à l'autre.
Consultez la documentation du ou des contrôleurs d'Ingress que vous avez choisis pour
comprendre le fonctionnement de TLS dans votre environnement.
Équilibrage de charge
Un contrôleur d'Ingress démarre avec des réglages de politique d'équilibrage de charge
qu'il applique à tous les Ingress, comme l'algorithme d'équilibrage de charge, le schéma de pondération
des backends, etc. Les concepts d'équilibrage de charge plus avancés
(par exemple les sessions persistantes ou les pondérations dynamiques) ne sont pas encore exposés via
l'Ingress. Vous pouvez en revanche obtenir ces fonctionnalités grâce à l'équilibreur de charge utilisé pour
un Service.
Notez aussi que, même si les contrôles de santé (health checks) ne sont pas exposés directement
via l'Ingress, il existe dans Kubernetes des concepts parallèles, comme les
sondes de disponibilité (readiness probes),
qui permettent d'obtenir le même résultat. Consultez la documentation propre
à votre contrôleur pour savoir comment il gère les contrôles de santé.
Mettre à jour un Ingress
Pour mettre à jour un Ingress existant afin d'ajouter un nouvel hôte, vous pouvez modifier la ressource :
kubectl describe ingress test
Name:             test
Namespace:        default
Address:          178.91.123.132
Default backend:  default-http-backend:80 (10.8.2.3:8080)
Rules:
  Host         Path  Backends
  ----         ----  --------
  foo.bar.com
               /foo   service1:80 (10.8.0.90:80)
Events:
  Type     Reason  Age                From                     Message
  ----     ------  ----               ----                     -------
  Normal   ADD     35s                loadbalancer-controller  default/test
kubectl edit ingress test
Un éditeur s'ouvre avec la configuration existante au format YAML.
Modifiez-la pour ajouter le nouvel hôte :
Une fois vos modifications enregistrées, kubectl met à jour la ressource dans le serveur d'API, ce qui indique
au contrôleur d'Ingress de reconfigurer l'équilibreur de charge.
Vérifiez-le :
kubectl describe ingress test
Name:             test
Namespace:        default
Address:          178.91.123.132
Default backend:  default-http-backend:80 (10.8.2.3:8080)
Rules:
  Host         Path  Backends
  ----         ----  --------
  foo.bar.com
               /foo   service1:80 (10.8.0.90:80)
  bar.baz.com
               /foo   service2:80 (10.8.0.91:80)
Events:
  Type     Reason  Age                From                     Message
  ----     ------  ----               ----                     -------
  Normal   ADD     45s                loadbalancer-controller  default/test
Vous pouvez obtenir le même résultat en exécutant kubectl replace -f sur un fichier YAML d'Ingress modifié.
Basculement entre zones de disponibilité
Les techniques de répartition du trafic entre domaines de défaillance diffèrent d'un fournisseur de cloud à l'autre.
Consultez la documentation du contrôleur d'Ingress concerné pour plus de détails.
Alternatives
Vous pouvez exposer un Service de plusieurs manières qui n'impliquent pas directement la ressource Ingress :
Pour qu'un Ingress fonctionne dans votre cluster, un contrôleur d'Ingress doit être en cours d'exécution. Vous devez choisir au moins un contrôleur d'Ingress et vous assurer qu'il est mis en place dans votre cluster. Cette page liste des contrôleurs d'Ingress courants que vous pouvez déployer.
Note:
Le projet Kubernetes recommande d'utiliser Gateway plutôt
qu'Ingress.
L'API Ingress est figée.
Cela signifie que :
L'API Ingress est en disponibilité générale (GA) et soumise aux garanties de stabilité prévues pour les API GA.
Le projet Kubernetes n'a pas l'intention de retirer Ingress de Kubernetes.
L'API Ingress n'est plus développée et ne recevra plus aucune modification
ni mise à jour.
Contrôleurs d'Ingress
Le projet Kubernetes prend en charge et maintient les contrôleurs d'Ingress AWS et GCE.
Contrôleurs d'Ingress tiers
Note: Cette section renvoie à des projets tiers qui fournissent des fonctionnalités requises par Kubernetes. Les auteurs du projet Kubernetes ne sont pas responsables de ces projets, classés par ordre alphabétique. Pour ajouter un projet à cette liste, lisez le guide avant de soumettre une modification. Plus d'informations.
ngrok-operator est un contrôleur pour ngrok qui prend en charge à la fois Ingress et Gateway API pour exposer vos Services K8s de manière sécurisée sur Internet.
Skipper est un routeur HTTP et un proxy inverse pour la composition de services, y compris pour des cas d'usage comme Kubernetes Ingress, conçu comme une bibliothèque pour construire votre propre proxy.
Tyk Operator étend Ingress avec des ressources personnalisées pour lui apporter des fonctionnalités de gestion d'API. Tyk Operator fonctionne avec Tyk Gateway (open source) et avec le plan de contrôle Tyk Cloud.
Wallarm Ingress Controller est un contrôleur d'Ingress qui fournit des fonctionnalités de WAAP (WAF) et de sécurité des API.
Utiliser plusieurs contrôleurs d'Ingress
Vous pouvez déployer autant de contrôleurs d'Ingress que vous le souhaitez dans un cluster, grâce aux
classes d'Ingress. Notez le .metadata.name de votre ressource de classe d'Ingress. Lorsque vous créez un Ingress, vous avez besoin de ce nom pour renseigner le champ ingressClassName de votre objet Ingress (voir la référence IngressSpec v1). ingressClassName remplace l'ancienne méthode par annotation.
Si vous ne précisez pas d'IngressClass pour un Ingress et que votre cluster a exactement une IngressClass marquée comme classe par défaut, Kubernetes applique cette IngressClass par défaut du cluster à l'Ingress.
Pour marquer une IngressClass comme classe par défaut, définissez l'annotation ingressclass.kubernetes.io/is-default-class sur cette IngressClass, avec la chaîne "true".
Idéalement, tous les contrôleurs d'Ingress devraient respecter cette spécification, mais les différents
contrôleurs d'Ingress fonctionnent de manière légèrement différente.
Note:
Consultez bien la documentation de votre contrôleur d'Ingress pour connaître les points d'attention liés à ce choix.
Gateway API est une famille de types d'API qui fournissent un provisionnement dynamique de l'infrastructure et un routage avancé du trafic.
Rendez des services réseau accessibles grâce à un mécanisme de configuration extensible, orienté
rôles et conscient des protocoles. Gateway API est un add-on
qui contient des types d'API fournissant un
provisionnement dynamique de l'infrastructure et un routage avancé du trafic.
Principes de conception
Les principes suivants ont guidé la conception et l'architecture de Gateway API :
Orientée rôles : les types de Gateway API sont modélisés d'après les rôles organisationnels
chargés de gérer le réseau des services Kubernetes :
Fournisseur d'infrastructure : gère une infrastructure qui permet à plusieurs clusters isolés
de servir plusieurs locataires, par exemple un fournisseur de cloud.
Opérateur de cluster : gère des clusters et s'occupe généralement des politiques, de l'accès
réseau, des permissions des applications, etc.
Développeur d'applications : gère une application qui s'exécute dans un cluster et s'occupe
généralement de la configuration au niveau de l'application et de la composition des
Services.
Expressive : les types de Gateway API prennent en charge des fonctionnalités couvrant les cas
d'usage courants de routage du trafic, comme la correspondance sur les en-têtes ou la pondération
du trafic, entre autres, qui n'étaient possibles avec Ingress
qu'au moyen d'annotations personnalisées.
Extensible : Gateway permet de lier des ressources personnalisées à différents niveaux de l'API.
Cela rend possible une personnalisation fine aux endroits appropriés de la structure de l'API.
Modèle de ressources
Gateway API comporte quatre types d'API stables :
GatewayClass : définit un ensemble de gateways partageant une configuration commune et gérées
par un contrôleur qui implémente la classe.
Gateway : définit une instance d'infrastructure de traitement du trafic, comme un équilibreur de charge (load balancer) cloud.
HTTPRoute : définit des règles propres à HTTP pour acheminer le trafic d'un listener de Gateway
vers une représentation de points de terminaison réseau de backend. Ces points de terminaison sont
souvent représentés par un Service.
GRPCRoute : définit des règles propres à gRPC pour acheminer le trafic d'un listener de Gateway
vers une représentation de points de terminaison réseau de backend. Ces points de terminaison sont
souvent représentés par un Service.
Gateway API est organisée en différents types d'API liés par des relations d'interdépendance, afin de
refléter l'organisation par rôles des entreprises. Un objet Gateway est associé à exactement une GatewayClass ;
la GatewayClass décrit le contrôleur de gateway chargé de gérer les Gateways de cette classe.
Un ou plusieurs types de routes, comme HTTPRoute, sont ensuite associés aux Gateways. Une Gateway peut
filtrer les routes autorisées à se rattacher à ses listeners, ce qui forme un modèle de confiance
bidirectionnel avec les routes.
La figure suivante illustre les relations entre les trois types stables de Gateway API :
GatewayClass
Les Gateways peuvent être implémentées par différents contrôleurs, souvent avec des configurations
différentes. Une Gateway doit référencer une GatewayClass qui contient le nom du contrôleur qui
implémente la classe.
Dans cet exemple, un contrôleur qui implémente Gateway API est configuré pour gérer les GatewayClasses
dont le nom de contrôleur est example.com/gateway-controller. Les Gateways de cette classe seront
gérées par le contrôleur de l'implémentation.
Consultez la référence de GatewayClass
pour la définition complète de ce type d'API.
Gateway
Une Gateway décrit une instance d'infrastructure de traitement du trafic. Elle définit un point de
terminaison réseau qui peut servir à traiter le trafic, c'est-à-dire à le filtrer, à en équilibrer la charge, à le
fractionner, etc., vers des backends comme un Service. Par exemple, une Gateway peut représenter un
équilibreur de charge cloud ou un serveur proxy interne au cluster, configuré pour accepter du trafic HTTP.
Dans cet exemple, une instance d'infrastructure de traitement du trafic est programmée pour écouter
le trafic HTTP sur le port 80. Comme le champ addresses n'est pas renseigné, une adresse ou un nom
d'hôte est attribué à la Gateway par le contrôleur de l'implémentation. Cette adresse sert de point
de terminaison réseau pour traiter le trafic destiné aux points de terminaison réseau de backend
définis dans les routes.
Consultez la référence de Gateway
pour la définition complète de ce type d'API. Pour configurer des listeners HTTPS/TLS, consultez le
guide TLS de Gateway API.
Note:
Par défaut, une Gateway n'accepte que les routes du même namespace. Les routes situées dans d'autres namespaces nécessitent de configurer allowedRoutes.
HTTPRoute
Le type HTTPRoute définit le comportement de routage des requêtes HTTP, d'un listener de Gateway vers
des points de terminaison réseau de backend. Pour un backend de type Service, une implémentation peut
représenter le point de terminaison réseau du backend par l'IP du Service ou par les EndpointSlices
associées au Service. Une HTTPRoute représente une configuration appliquée à l'implémentation de
Gateway sous-jacente. Par exemple, définir une nouvelle HTTPRoute peut conduire à configurer des
routes de trafic supplémentaires dans un équilibreur de charge cloud ou dans un serveur proxy du cluster.
Dans cet exemple, le trafic HTTP provenant de la Gateway example-gateway, dont l'en-tête Host: vaut
www.example.com et dont le chemin de la requête est /login, sera acheminé vers le Service
example-svc sur le port 8080.
Consultez la référence de HTTPRoute
pour la définition complète de ce type d'API.
GRPCRoute
Le type GRPCRoute définit le comportement de routage des requêtes gRPC, d'un listener de Gateway vers
des points de terminaison réseau de backend. Pour un backend de type Service, une implémentation peut
représenter le point de terminaison réseau du backend par l'IP du Service ou par les EndpointSlices
associées au Service. Une GRPCRoute représente une configuration appliquée à l'implémentation de
Gateway sous-jacente. Par exemple, définir une nouvelle GRPCRoute peut conduire à configurer des
routes de trafic supplémentaires dans un équilibreur de charge cloud ou dans un serveur proxy du cluster.
Les Gateways qui prennent en charge GRPCRoute doivent prendre en charge HTTP/2 sans mise à niveau
initiale depuis HTTP/1, afin de garantir que le trafic gRPC circule correctement.
Dans cet exemple, le trafic gRPC provenant de la Gateway example-gateway, dont l'hôte est
svc.example.com, sera dirigé vers le Service example-svc sur le port 50051, dans le même namespace.
GRPCRoute permet de cibler des services gRPC précis, comme dans l'exemple suivant :
Dans ce cas, la GRPCRoute correspond à tout le trafic destiné à svc.example.com et applique ses règles
de routage pour transmettre le trafic au bon backend. Comme une seule correspondance est définie,
seules les requêtes vers la méthode com.example.User.Login sur svc.example.com seront
transmises. Les RPC vers toute autre méthode ne correspondront pas à cette route.
Consultez la référence de GRPCRoute
pour la définition complète de ce type d'API.
Flux des requêtes
Voici un exemple simple de trafic HTTP acheminé vers un Service à l'aide d'une Gateway et d'une HTTPRoute :
Dans cet exemple, le flux d'une requête pour une Gateway implémentée sous forme de proxy inverse est le suivant :
Le client commence à préparer une requête HTTP pour l'URL http://www.example.com.
Le résolveur DNS du client résout le nom de destination en
une ou plusieurs adresses IP associées à la Gateway.
Le client envoie une requête à l'adresse IP de la Gateway ; le proxy inverse reçoit la requête
HTTP et utilise l'en-tête Host: pour trouver une configuration issue de la Gateway et de
l'HTTPRoute rattachée.
Le proxy inverse peut éventuellement vérifier la correspondance des en-têtes et/ou du chemin
de la requête, selon les règles de correspondance de l'HTTPRoute.
Le proxy inverse peut éventuellement modifier la requête, par exemple pour ajouter ou supprimer
des en-têtes, selon les règles de filtrage de l'HTTPRoute.
Enfin, le proxy inverse transmet la requête à un ou plusieurs backends.
Conformité
Gateway API couvre un large ensemble de fonctionnalités et elle est largement implémentée. Cette
combinaison exige des définitions et des tests de conformité clairs pour garantir que l'API offre
une expérience cohérente partout où elle est utilisée.
Consultez la documentation sur la conformité
pour comprendre des notions comme les canaux de publication, les niveaux de prise en charge et
l'exécution des tests de conformité.
Migrer depuis Ingress
Gateway API succède à l'API Ingress.
Elle n'inclut cependant pas le type Ingress. Une conversion ponctuelle de vos ressources Ingress
existantes en ressources Gateway API est donc nécessaire.
Consultez le guide de migration depuis Ingress
pour savoir comment migrer des ressources Ingress vers des ressources Gateway API.
A suivre
Les ressources de Gateway API ne sont pas implémentées nativement par Kubernetes : leurs spécifications
sont définies sous forme de ressources personnalisées
prises en charge par un large éventail d'implémentations.
Installez les CRD de Gateway API ou
suivez les instructions d'installation de l'implémentation choisie. Une fois l'implémentation installée,
utilisez le guide Getting Started pour prendre en main
rapidement Gateway API.
Note:
Consultez la documentation de l'implémentation choisie pour bien en comprendre les éventuelles limites.
Consultez la spécification de l'API pour plus
de détails sur tous les types de Gateway API.
5 - EndpointSlices
L'API EndpointSlice est le mécanisme que Kubernetes utilise pour permettre à votre Service de passer à l'échelle et de gérer un grand nombre de backends, et elle permet au cluster de mettre à jour efficacement sa liste de backends sains.
Feature state:Stable since Kubernetes v1.21
Les EndpointSlices suivent les adresses IP des points de terminaison backend. Les EndpointSlices sont généralement associés à un Service et les points de terminaison backend représentent typiquement des Pods.
API EndpointSlice
Dans Kubernetes, un EndpointSlice contient des références à un ensemble de points
de terminaison réseau. Le plan de contrôle crée automatiquement des EndpointSlices
pour tout Service Kubernetes pour lequel un sélecteur est spécifié. Ces EndpointSlices contiennent des
références à tous les Pods qui correspondent au sélecteur du Service. Les EndpointSlices
regroupent les points de terminaison réseau par combinaison unique de famille d'adresses IP,
de protocole, de numéro de port et de nom de Service.
Le nom d'un objet EndpointSlice doit être un
nom de sous-domaine DNS valide.
Voici par exemple un objet EndpointSlice dont le propriétaire est le Service Kubernetes
example.
Par défaut, le plan de contrôle crée et gère des EndpointSlices qui ne contiennent
pas plus de 100 points de terminaison chacun. Vous pouvez modifier cette valeur avec l'option
--max-endpoints-per-slice de
kube-controller-manager,
jusqu'à un maximum de 1000.
Les EndpointSlices constituent la source de vérité de
kube-proxy pour déterminer
comment acheminer le trafic interne.
Types d'adresses
Les EndpointSlices prennent en charge deux types d'adresses :
IPv4
IPv6
Chaque objet EndpointSlice correspond à un type d'adresse IP précis. Si vous avez
un Service accessible en IPv4 et en IPv6, il existera au moins deux objets
EndpointSlice (un pour IPv4 et un pour IPv6).
Conditions
L'API EndpointSlice enregistre, pour les points de terminaison, des conditions qui peuvent être utiles à ses consommateurs.
Les trois conditions sont serving, terminating et ready.
Serving
Feature state:Stable since Kubernetes v1.26
La condition serving indique que le point de terminaison répond actuellement aux requêtes, et
qu'il devrait donc être utilisé comme cible pour le trafic du Service. Pour les points de terminaison
adossés à un Pod, elle correspond à la condition Ready du Pod.
Terminating
Feature state:Stable since Kubernetes v1.26
La condition terminating indique que le point de terminaison est
en cours d'arrêt. Pour les points de terminaison adossés à un Pod, cette condition est définie
dès que la suppression du Pod est demandée (c'est-à-dire lorsqu'il reçoit un horodatage
de suppression, mais très probablement avant que les conteneurs du Pod ne s'arrêtent).
Les proxys de Service ignorent normalement les points de terminaison marqués terminating,
mais ils peuvent acheminer le trafic vers des points de terminaison à la fois serving et
terminating si tous les points de terminaison disponibles sont marqués terminating. (Cela
contribue à garantir qu'aucun trafic du Service n'est perdu pendant les mises à jour progressives
des Pods sous-jacents.)
Ready
La condition ready est essentiellement un raccourci pour vérifier
« serving et non terminating » (elle vaut toutefois toujours
true pour les Services dont spec.publishNotReadyAddresses est défini sur
true).
Informations de topologie
Chaque point de terminaison d'un EndpointSlice peut contenir des informations de topologie pertinentes.
Ces informations comprennent l'emplacement du point de terminaison ainsi que des informations
sur le nœud et la zone correspondants. Elles sont disponibles dans les champs suivants,
propres à chaque point de terminaison d'un EndpointSlice :
nodeName : le nom du nœud sur lequel se trouve ce point de terminaison.
zone : la zone dans laquelle se trouve ce point de terminaison.
Gestion
Le plus souvent, c'est le plan de contrôle (plus précisément, le
contrôleur d'EndpointSlices) qui crée et
gère les objets EndpointSlice. Les EndpointSlices ont de nombreux autres cas d'usage,
comme les implémentations de service mesh, qui peuvent amener d'autres entités
ou contrôleurs à gérer des ensembles supplémentaires d'EndpointSlices.
Pour que plusieurs entités puissent gérer des EndpointSlices sans se gêner
mutuellement, Kubernetes définit le
labelendpointslice.kubernetes.io/managed-by, qui indique l'entité qui gère
un EndpointSlice.
Le contrôleur d'EndpointSlices attribue la valeur endpointslice-controller.k8s.io
à ce label sur tous les EndpointSlices qu'il gère. Les autres entités qui gèrent
des EndpointSlices doivent elles aussi attribuer une valeur unique à ce label.
Propriété
Dans la plupart des cas d'usage, le propriétaire d'un EndpointSlice est le Service dont
l'objet EndpointSlice suit les points de terminaison. Cette propriété est indiquée par une référence
de propriétaire (owner reference) sur chaque EndpointSlice, ainsi que par un label
kubernetes.io/service-name qui permet de retrouver simplement tous les EndpointSlices
d'un Service.
Répartition des EndpointSlices
Chaque EndpointSlice possède un ensemble de ports qui s'applique à tous les points de terminaison
de la ressource. Lorsqu'un Service utilise des ports nommés, les Pods peuvent se retrouver avec
des numéros de port cible différents pour un même port nommé, ce qui nécessite des
EndpointSlices distincts.
Le plan de contrôle essaie de remplir les EndpointSlices autant que possible, mais ne
les rééquilibre pas activement. La logique est assez simple :
Parcourir les EndpointSlices existants, retirer les points de terminaison qui ne sont plus
souhaités et mettre à jour les points de terminaison correspondants qui ont changé.
Parcourir les EndpointSlices modifiés lors de la première étape et
les compléter avec les nouveaux points de terminaison nécessaires.
S'il reste encore de nouveaux points de terminaison à ajouter, essayer de les placer dans un
EndpointSlice resté inchangé et/ou en créer de nouveaux.
Point important : la troisième étape privilégie la limitation des mises à jour d'EndpointSlices
plutôt qu'un remplissage optimal des EndpointSlices. Par exemple, s'il y a 10
nouveaux points de terminaison à ajouter et 2 EndpointSlices pouvant chacun en accueillir 5 de plus,
cette approche créera un nouvel EndpointSlice au lieu de remplir les 2
EndpointSlices existants. Autrement dit, une seule création d'EndpointSlice est
préférable à plusieurs mises à jour d'EndpointSlices.
Comme kube-proxy s'exécute sur chaque nœud et surveille les EndpointSlices, chaque modification
d'un EndpointSlice devient relativement coûteuse, puisqu'elle est transmise à
chaque nœud du cluster. Cette approche vise à limiter le nombre de
modifications à envoyer à chaque nœud, même si elle peut aboutir à plusieurs
EndpointSlices partiellement remplis.
En pratique, cette répartition moins qu'idéale devrait être rare. La plupart des modifications
traitées par le contrôleur d'EndpointSlices sont suffisamment petites pour tenir dans un
EndpointSlice existant ; dans le cas contraire, un nouvel EndpointSlice sera de toute façon
probablement nécessaire bientôt. Les mises à jour progressives des Deployments entraînent
aussi un réagencement naturel des EndpointSlices, puisque tous les Pods et leurs points de terminaison
correspondants sont remplacés.
Points de terminaison en double
En raison de la nature des modifications d'EndpointSlices, un point de terminaison peut figurer dans
plusieurs EndpointSlices en même temps. Cela se produit naturellement, car les modifications de
différents objets EndpointSlice peuvent parvenir au watch / cache du client Kubernetes
à des moments différents.
Note:
Les clients de l'API EndpointSlice doivent parcourir tous les EndpointSlices existants
associés à un Service et construire une liste complète de points de terminaison réseau uniques.
Il est important de noter que des points de terminaison peuvent être dupliqués dans différents EndpointSlices.
Vous trouverez une implémentation de référence de cette agrégation et de cette
déduplication des points de terminaison dans le code EndpointSliceCache de kube-proxy.
Mise en miroir des EndpointSlices
Feature state:Deprecated since Kubernetes v1.33
L'API EndpointSlice remplace l'ancienne API Endpoints. Pour
préserver la compatibilité avec les anciens contrôleurs et les charges de travail des utilisateurs qui
s'attendent à ce que kube-proxy
achemine le trafic à partir des ressources Endpoints, le plan de contrôle du cluster
reproduit (en miroir) la plupart des ressources Endpoints créées par les utilisateurs
dans des EndpointSlices correspondants.
(Cette fonctionnalité est toutefois dépréciée, comme le reste de l'API Endpoints.
Les utilisateurs qui définissent manuellement des points de terminaison pour des Services
sans sélecteur doivent le faire en créant directement des ressources EndpointSlice,
plutôt qu'en créant des ressources Endpoints et en laissant le plan de contrôle les reproduire en miroir.)
Le plan de contrôle reproduit les ressources Endpoints en miroir, sauf si :
la ressource Endpoints a un label endpointslice.kubernetes.io/skip-mirror
défini sur true ;
la ressource Endpoints a une annotation control-plane.alpha.kubernetes.io/leader ;
la ressource Service correspondante n'existe pas ;
la ressource Service correspondante a un sélecteur non nul.
Une même ressource Endpoints peut donner lieu à plusieurs EndpointSlices. C'est le
cas si une ressource Endpoints comporte plusieurs sous-ensembles (subsets) ou contient des points
de terminaison de plusieurs familles d'adresses IP (IPv4 et IPv6). Au maximum 1000 adresses par
sous-ensemble sont reproduites dans les EndpointSlices.
Si vous voulez contrôler les flux de trafic au niveau des adresses IP ou des ports (couches 3 ou 4 du modèle OSI), les NetworkPolicies vous permettent de définir des règles pour les flux de trafic au sein de votre cluster, ainsi qu'entre les Pods et le monde extérieur. Votre cluster doit utiliser un plugin réseau qui sait faire respecter les NetworkPolicies.
Si vous voulez contrôler les flux de trafic au niveau des adresses IP ou des ports pour les protocoles TCP, UDP et SCTP,
vous pouvez envisager d'utiliser les NetworkPolicies de Kubernetes pour certaines applications de votre cluster.
Les NetworkPolicies sont un mécanisme centré sur l'application, qui vous permet de définir comment un
pod est autorisé à communiquer sur le réseau avec différentes
« entités » (nous employons ici le mot « entité » pour ne pas donner un sens de plus à des termes courants comme
« endpoints » et « services », qui ont un sens précis dans Kubernetes).
Les NetworkPolicies s'appliquent à une connexion dont l'une des extrémités au moins est un pod, et ne concernent pas
les autres connexions.
Les entités avec lesquelles un Pod peut communiquer sont identifiées par une combinaison des
trois identifiants suivants :
Les autres pods autorisés (exception : un pod ne peut pas bloquer l'accès à lui-même)
Les namespaces autorisés
Les blocs d'adresses IP (exception : le trafic depuis et vers le nœud sur lequel un Pod s'exécute est toujours autorisé,
quelle que soit l'adresse IP du Pod ou du nœud)
Pour définir une NetworkPolicy basée sur les pods ou les namespaces, vous utilisez un
sélecteur pour indiquer quel trafic est autorisé
depuis et vers le ou les Pods qui correspondent à ce sélecteur.
Pour les NetworkPolicies basées sur les adresses IP, en revanche, on définit des politiques à partir de blocs d'adresses IP (plages CIDR).
Prérequis
Les politiques réseau sont mises en œuvre par le plugin réseau.
Pour utiliser les politiques réseau, il vous faut une solution réseau qui prend en charge les NetworkPolicies.
Créer une ressource NetworkPolicy sans contrôleur pour la mettre en œuvre n'aura aucun effet.
Les deux types d'isolation d'un pod
Un pod peut être isolé de deux façons : en sortie (egress) et en entrée (ingress).
Ces isolations portent sur les connexions qui peuvent être établies. Ici, « isolé » n'a rien d'absolu :
cela signifie que « certaines restrictions s'appliquent ». À l'inverse, « non isolé dans une direction » signifie
qu'aucune restriction ne s'applique dans cette direction. Les deux types d'isolation (ou leur absence) sont déclarés
indépendamment l'un de l'autre, et entrent tous deux en jeu pour une connexion d'un pod vers un autre.
Par défaut, un pod n'est pas isolé en sortie : toutes les connexions sortantes sont autorisées.
Un pod est isolé en sortie s'il existe au moins une NetworkPolicy qui sélectionne ce pod et dont
les policyTypes contiennent « Egress » ; on dit alors que cette politique s'applique au pod en sortie.
Quand un pod est isolé en sortie, les seules connexions autorisées depuis ce pod sont celles qu'autorise
la liste egress d'au moins une NetworkPolicy qui s'applique au pod en sortie. Le trafic de réponse
de ces connexions autorisées est lui aussi autorisé implicitement.
Les effets de ces listes egress s'additionnent.
Par défaut, un pod n'est pas isolé en entrée : toutes les connexions entrantes sont autorisées.
Un pod est isolé en entrée s'il existe au moins une NetworkPolicy qui sélectionne ce pod et dont
les policyTypes contiennent « Ingress » ; on dit alors que cette politique s'applique au pod en entrée.
Quand un pod est isolé en entrée, les seules connexions autorisées vers ce pod sont celles qui viennent
du nœud du pod et celles qu'autorise la liste ingress d'au moins une NetworkPolicy qui s'applique
au pod en entrée. Le trafic de réponse de ces connexions autorisées est lui aussi autorisé implicitement.
Les effets de ces listes ingress s'additionnent.
Les politiques réseau n'entrent pas en conflit : elles s'additionnent. Si une ou plusieurs politiques s'appliquent
à un pod donné dans une direction donnée, les connexions autorisées dans cette direction pour ce pod sont l'union
de ce qu'autorisent ces politiques. L'ordre d'évaluation n'a donc aucune influence sur le résultat.
Pour qu'une connexion d'un pod source vers un pod de destination soit autorisée, il faut que la politique
en sortie du pod source et la politique en entrée du pod de destination l'autorisent toutes les deux.
Si l'un des deux côtés ne l'autorise pas, la connexion n'a pas lieu.
La ressource NetworkPolicy
Consultez la référence NetworkPolicy
pour la définition complète de la ressource.
Envoyer cette ressource (POST) au serveur d'API de votre cluster n'aura aucun effet si la solution réseau
que vous avez choisie ne prend pas en charge les politiques réseau.
Champs obligatoires : comme toute autre configuration Kubernetes, une NetworkPolicy a besoin des champs apiVersion,
kind et metadata. Pour des informations générales sur l'utilisation des fichiers de configuration, consultez
Configurer un Pod pour utiliser une ConfigMap
et Gestion des objets.
spec : la spec
d'une NetworkPolicy contient toutes les informations nécessaires pour définir une politique réseau donnée dans le namespace concerné.
podSelector : chaque NetworkPolicy contient un podSelector qui sélectionne le groupe de pods
auquel la politique s'applique. La politique de l'exemple sélectionne les pods qui ont le label « role=db ». Un
podSelector vide sélectionne tous les pods du namespace.
policyTypes : chaque NetworkPolicy contient une liste policyTypes qui peut contenir Ingress,
Egress ou les deux. Le champ policyTypes indique si la politique s'applique au trafic
entrant vers les pods sélectionnés, au trafic sortant des pods sélectionnés, ou aux deux. Si aucun
policyTypes n'est indiqué dans une NetworkPolicy, Ingress est toujours défini par défaut, et
Egress l'est aussi si la NetworkPolicy contient des règles egress.
ingress : chaque NetworkPolicy peut contenir une liste de règles ingress autorisées. Chaque règle autorise
le trafic qui correspond à la fois aux sections from et ports. La politique de l'exemple contient une seule
règle, qui correspond au trafic sur un seul port, depuis l'une de trois sources : la première définie par
un ipBlock, la deuxième par un namespaceSelector et la troisième par un podSelector.
egress : chaque NetworkPolicy peut contenir une liste de règles egress autorisées. Chaque règle autorise
le trafic qui correspond à la fois aux sections to et ports. La politique de l'exemple contient une seule
règle, qui correspond au trafic sur un seul port vers n'importe quelle destination dans 10.0.0.0/24.
La NetworkPolicy de l'exemple a donc les effets suivants :
elle isole les pods role=db du namespace default pour le trafic entrant et sortant
(s'ils n'étaient pas déjà isolés)
(règles Ingress) elle autorise les connexions vers tous les pods du namespace default qui ont le label
role=db, sur le port TCP 6379, depuis :
n'importe quel pod du namespace default qui a le label role=frontend
n'importe quel pod d'un namespace qui a le label project=myproject
les adresses IP des plages 172.17.0.0–172.17.0.255 et 172.17.2.0–172.17.255.255
(c'est-à-dire tout 172.17.0.0/16 sauf 172.17.1.0/24)
(règles Egress) elle autorise les connexions depuis n'importe quel pod du namespace default qui a le label
role=db vers le CIDR 10.0.0.0/24, sur le port TCP 5978
Quatre types de sélecteurs peuvent être indiqués dans une section from d'ingress ou dans une section to
d'egress :
podSelector : sélectionne certains Pods du même namespace que la NetworkPolicy, qui doivent être
autorisés comme sources en entrée ou comme destinations en sortie.
namespaceSelector : sélectionne certains namespaces dont tous les Pods doivent être autorisés comme
sources en entrée ou comme destinations en sortie.
namespaceSelectoretpodSelector : une même entrée to/from qui indique à la fois
namespaceSelector et podSelector sélectionne certains Pods dans certains namespaces. Veillez
à utiliser une syntaxe YAML correcte. Par exemple :
Cette politique contient un seul élément from, qui autorise les connexions depuis les Pods qui ont le label
role=client dans les namespaces qui ont le label user=alice. La politique suivante, elle, est différente :
Elle contient deux éléments dans le tableau from, et autorise les connexions depuis les Pods du
namespace local qui ont le label role=client, ou depuis n'importe quel Pod de n'importe quel namespace qui a le label
user=alice.
En cas de doute, utilisez kubectl describe pour voir comment Kubernetes a interprété la politique.
ipBlock : sélectionne certaines plages CIDR d'adresses IP à autoriser comme sources en entrée ou comme
destinations en sortie. Il devrait s'agir d'adresses IP externes au cluster, car les adresses IP des Pods sont éphémères et imprévisibles.
Les mécanismes d'entrée et de sortie du cluster doivent souvent réécrire l'adresse IP source ou de destination
des paquets. Lorsque c'est le cas, rien ne définit si cette réécriture a lieu avant ou
après le traitement des NetworkPolicies, et le comportement peut varier selon la
combinaison de plugin réseau, de fournisseur cloud, d'implémentation des Service, etc.
En entrée, cela veut dire que, dans certains cas, vous pourrez filtrer les paquets entrants
selon leur véritable adresse IP source d'origine, alors que dans d'autres cas, l'« adresse IP source »
prise en compte par la NetworkPolicy peut être celle d'un LoadBalancer, du nœud du Pod, etc.
En sortie, cela veut dire que les connexions des pods vers des adresses IP de Service réécrites en
adresses IP externes au cluster peuvent être soumises ou non aux politiques basées sur ipBlock.
Politiques par défaut
Par défaut, s'il n'existe aucune politique dans un namespace, tout le trafic entrant et sortant est autorisé
vers et depuis les pods de ce namespace. Les exemples suivants vous permettent de modifier ce comportement par défaut
dans ce namespace.
Refuser par défaut tout le trafic entrant
Pour créer une politique d'isolation en entrée « par défaut » dans un namespace, créez une NetworkPolicy
qui sélectionne tous les pods mais n'autorise aucun trafic entrant vers ces pods.
Ainsi, même les pods qui ne sont sélectionnés par aucune autre NetworkPolicy restent isolés
en entrée. Cette politique n'a pas d'effet sur l'isolation en sortie des pods.
Autoriser tout le trafic entrant
Si vous voulez autoriser toutes les connexions entrantes vers tous les pods d'un namespace, vous pouvez créer une politique
qui les autorise explicitement.
Une fois cette politique en place, aucune autre politique ne peut entraîner le refus d'une connexion entrante
vers ces pods. Cette politique n'a pas d'effet sur l'isolation en sortie des pods.
Refuser par défaut tout le trafic sortant
Pour créer une politique d'isolation en sortie « par défaut » dans un namespace, créez une NetworkPolicy
qui sélectionne tous les pods mais n'autorise aucun trafic sortant depuis ces pods.
Ainsi, même les pods qui ne sont sélectionnés par aucune autre NetworkPolicy n'ont droit à aucun
trafic sortant. Cette politique ne change pas le comportement d'isolation en entrée des pods.
Avertissement:
Une politique qui refuse par défaut tout le trafic sortant bloque aussi le trafic DNS. Si vos charges de travail
ont besoin de la résolution DNS, vous devez ajouter une NetworkPolicy distincte qui autorise le trafic sortant
vers le service DNS de votre cluster.
Autoriser tout le trafic sortant
Si vous voulez autoriser toutes les connexions depuis tous les pods d'un namespace, vous pouvez créer une politique qui
autorise explicitement toutes les connexions sortantes des pods de ce namespace.
Une fois cette politique en place, aucune autre politique ne peut entraîner le refus d'une connexion sortante
depuis ces pods. Cette politique n'a pas d'effet sur l'isolation en entrée des pods.
Refuser par défaut tout le trafic entrant et sortant
Vous pouvez créer une politique « par défaut » pour un namespace qui empêche tout le trafic entrant ET sortant
en créant la NetworkPolicy suivante dans ce namespace.
Ainsi, même les pods qui ne sont sélectionnés par aucune autre NetworkPolicy n'ont droit à aucun
trafic entrant ni sortant.
Filtrage du trafic réseau
Les NetworkPolicies sont définies pour les connexions de couche 4
(TCP, UDP et, en option, SCTP). Pour tous les autres protocoles, le comportement peut varier
d'un plugin réseau à l'autre.
Note:
Vous devez utiliser un plugin CNI qui prend en charge
les NetworkPolicies pour le protocole SCTP.
Lorsqu'une politique réseau deny all est définie, elle ne garantit que le refus des connexions TCP, UDP et SCTP.
Pour les autres protocoles, comme ARP ou ICMP, le comportement n'est pas défini.
Il en va de même pour les règles d'autorisation : quand un pod précis est autorisé comme source en entrée ou comme destination en sortie,
ce qu'il advient des paquets ICMP, par exemple, n'est pas défini. Des protocoles comme ICMP peuvent être autorisés par certains
plugins réseau et refusés par d'autres.
Cibler une plage de ports
Feature state:Stable since Kubernetes v1.25
Quand vous écrivez une NetworkPolicy, vous pouvez cibler une plage de ports au lieu d'un seul port.
Pour cela, utilisez le champ endPort, comme dans l'exemple suivant :
La règle ci-dessus autorise n'importe quel Pod qui a le label role=db dans le namespace default à communiquer
avec n'importe quelle adresse IP de la plage 10.0.0.0/24 en TCP, à condition que le port
de destination soit compris entre 32000 et 32768.
Les restrictions suivantes s'appliquent à l'utilisation de ce champ :
Le champ endPort doit être supérieur ou égal au champ port.
endPort ne peut être défini que si port est aussi défini.
Les deux ports doivent être numériques.
Note:
Votre cluster doit utiliser un plugin CNI qui
prend en charge le champ endPort dans les spécifications des NetworkPolicies.
Si votre plugin réseau
ne prend pas en charge le champ endPort et que vous définissez une NetworkPolicy qui l'utilise,
seul le champ port sera pris en compte.
Cibler plusieurs namespaces par label
Dans ce scénario, votre NetworkPolicy Egress cible plusieurs namespaces grâce à leurs
labels. Pour que cela fonctionne, vous devez poser un label sur les namespaces cibles. Par exemple :
Il n'est pas possible d'indiquer directement le nom des namespaces dans une NetworkPolicy.
Vous devez utiliser un namespaceSelector avec matchLabels ou matchExpressions pour sélectionner
les namespaces selon leurs labels.
Cibler un namespace par son nom
Le plan de contrôle de Kubernetes pose sur tous les namespaces un label immuable kubernetes.io/metadata.name,
dont la valeur est le nom du namespace.
Une NetworkPolicy ne peut pas cibler un namespace par son nom via un champ de l'objet, mais vous pouvez utiliser
ce label standardisé pour cibler un namespace précis.
Cycle de vie d'un pod
Note:
Ce qui suit s'applique aux clusters qui disposent d'un plugin réseau conforme et d'une implémentation conforme
des NetworkPolicies.
Quand un nouvel objet NetworkPolicy est créé, le plugin réseau peut mettre un certain temps
à le prendre en compte. Si un pod concerné par une NetworkPolicy
est créé avant que le plugin réseau ait fini de traiter cette NetworkPolicy,
ce pod peut démarrer sans protection, et les règles d'isolation seront appliquées une fois
le traitement de la NetworkPolicy terminé.
Une fois la NetworkPolicy traitée par le plugin réseau :
Tous les nouveaux pods concernés par une NetworkPolicy donnée seront isolés avant de démarrer.
Les implémentations des NetworkPolicies doivent garantir que le filtrage est effectif pendant tout
le cycle de vie du Pod, dès le tout premier instant où l'un des conteneurs de ce Pod démarre.
Comme elles s'appliquent au niveau du Pod, les NetworkPolicies s'appliquent de la même façon aux conteneurs d'initialisation,
aux conteneurs sidecar et aux conteneurs ordinaires.
Les règles d'autorisation finiront par être appliquées après les règles d'isolation (ou peut-être en même temps).
Dans le pire des cas, un pod nouvellement créé peut n'avoir aucune connectivité réseau au démarrage, si
les règles d'isolation étaient déjà appliquées mais pas encore les règles d'autorisation.
Chaque NetworkPolicy créée finira par être traitée par un plugin réseau, mais l'API Kubernetes
ne permet pas de savoir à quel moment précis.
Les pods doivent donc pouvoir démarrer avec une connectivité réseau différente
de celle attendue. Si vous devez vous assurer que le pod peut joindre certaines destinations
avant de démarrer, vous pouvez utiliser un conteneur d'initialisation
qui attend que ces destinations soient joignables avant que le kubelet ne démarre les conteneurs de l'application.
Chaque NetworkPolicy finira par être appliquée à tous les pods sélectionnés.
Comme le plugin réseau peut mettre en œuvre les NetworkPolicies de manière distribuée,
il est possible que les pods aient une vue légèrement incohérente des politiques réseau
au moment de la création d'un pod, ou quand des pods ou des politiques changent.
Par exemple, un pod nouvellement créé qui doit pouvoir joindre à la fois le Pod A
sur le Nœud 1 et le Pod B sur le Nœud 2 peut constater qu'il joint le Pod A immédiatement,
mais qu'il ne peut joindre le Pod B que quelques secondes plus tard.
NetworkPolicy et pods hostNetwork
Le comportement des NetworkPolicies pour les pods hostNetwork n'est pas défini, mais il devrait se limiter à deux possibilités :
Le plugin réseau sait distinguer le trafic des pods hostNetwork de tout le reste du trafic
(y compris distinguer le trafic de différents pods hostNetwork sur
le même nœud), et applique les NetworkPolicies aux pods hostNetwork comme
aux pods qui utilisent le réseau des pods.
Le plugin réseau ne sait pas distinguer correctement le trafic des pods hostNetwork,
et ignore donc les pods hostNetwork lorsqu'il évalue podSelector et namespaceSelector.
Le trafic depuis et vers les pods hostNetwork est traité comme tout autre trafic depuis et vers l'adresse IP du nœud.
(C'est l'implémentation la plus courante.)
Cela s'applique quand
un pod hostNetwork est sélectionné par spec.podSelector.
...spec:podSelector:matchLabels:role:client...
un pod hostNetwork est sélectionné par un podSelector ou un namespaceSelector dans une règle ingress ou egress.
Par ailleurs, comme les pods hostNetwork ont la même adresse IP que le nœud sur lequel ils s'exécutent,
leurs connexions sont traitées comme des connexions du nœud. Par exemple, vous pouvez autoriser le trafic
venant d'un Pod hostNetwork avec une règle ipBlock.
Ce que les politiques réseau ne permettent pas de faire (du moins, pas encore)
Dans Kubernetes 1.37, les fonctionnalités suivantes n'existent pas dans
l'API NetworkPolicy, mais vous pouvez peut-être les contourner avec des composants du système d'exploitation
(comme SELinux, OpenVSwitch, IPTables, etc.), des technologies de couche 7 (contrôleurs
d'Ingress, implémentations de service mesh) ou des contrôleurs d'admission. Si vous découvrez la
sécurité réseau dans Kubernetes, sachez que les cas d'usage suivants ne peuvent pas (encore) être
mis en œuvre avec l'API NetworkPolicy.
Forcer le trafic interne du cluster à passer par une passerelle commune (un service mesh ou un autre proxy
est sans doute plus adapté).
Tout ce qui touche à TLS (utilisez un service mesh ou un contrôleur d'Ingress pour cela).
Des politiques propres à un nœud (vous pouvez utiliser la notation CIDR, mais vous ne pouvez pas cibler les nœuds
par leur identité Kubernetes).
Cibler des services par leur nom (vous pouvez en revanche cibler des pods ou des namespaces par leurs
labels, ce qui est souvent un bon moyen de contourner le problème).
Créer ou gérer des « demandes de politique » traitées par un tiers.
Des politiques par défaut appliquées à tous les namespaces ou à tous les pods (certains projets et distributions
Kubernetes tiers savent le faire).
Des outils avancés d'interrogation des politiques et d'analyse d'accessibilité.
Journaliser les événements de sécurité réseau (par exemple les connexions bloquées ou acceptées).
Refuser explicitement par une politique (actuellement, le modèle des NetworkPolicies refuse par
défaut et permet seulement d'ajouter des règles d'autorisation).
Empêcher le trafic de loopback ou le trafic entrant venant de l'hôte (les Pods ne peuvent pas, à l'heure actuelle, bloquer l'accès
à localhost, ni bloquer l'accès depuis le nœud sur lequel ils s'exécutent).
Impact des NetworkPolicies sur les connexions existantes
Quand l'ensemble des NetworkPolicies qui s'appliquent à une connexion existante change (parce que les NetworkPolicies
sont modifiées, ou parce que les labels concernés des namespaces ou des pods sélectionnés par la
politique, côté sujet comme côté pairs, changent pendant une connexion existante), c'est
l'implémentation qui détermine si le changement s'applique ou non à cette connexion existante.
Exemple : une politique est créée et refuse une connexion jusque-là autorisée. C'est l'implémentation
du plugin réseau sous-jacent qui détermine si cette nouvelle politique ferme ou non les connexions existantes.
Il est recommandé de ne pas modifier les politiques, les pods ou les namespaces d'une façon qui pourrait affecter les connexions existantes.
Retrouvez des exemples pour des
scénarios courants rendus possibles par la ressource NetworkPolicy.
7 - DNS pour les Services et les Pods
Vos charges de travail peuvent découvrir les Services de votre cluster grâce au DNS ; cette page explique comment cela fonctionne.
Kubernetes crée des enregistrements DNS pour les Services et les Pods. Vous pouvez joindre
les Services avec des noms DNS stables plutôt qu'avec des adresses IP.
Kubernetes publie des informations sur les Pods et les Services, qui servent
à configurer le DNS. Le kubelet configure le DNS des Pods pour que les conteneurs en cours d'exécution
puissent trouver les Services par leur nom plutôt que par leur adresse IP.
Les Services définis dans le cluster reçoivent des noms DNS. Par défaut, la
liste de recherche DNS d'un Pod client contient le namespace du Pod lui-même et le
domaine par défaut du cluster.
Namespaces des Services
Une requête DNS peut renvoyer des résultats différents selon le namespace du Pod qui
l'envoie. Les requêtes DNS qui n'indiquent pas de namespace sont limitées au namespace
du Pod. Pour accéder aux Services d'autres namespaces, indiquez le namespace dans la requête DNS.
Prenons par exemple un Pod dans un namespace test, et un Service data dans
le namespace prod.
Une requête pour data ne renvoie aucun résultat, car elle utilise le namespace test du Pod.
Une requête pour data.prod renvoie le résultat attendu, car elle indique le
namespace.
Les requêtes DNS peuvent être complétées à l'aide du fichier /etc/resolv.conf du Pod. Le kubelet
configure ce fichier pour chaque Pod. Par exemple, une requête pour data seul peut être
complétée en data.test.svc.cluster.local. Ce sont les valeurs de l'option search
qui servent à compléter les requêtes. Pour en savoir plus sur les requêtes DNS, consultez
la page de manuel de resolv.conf.
En résumé, un Pod du namespace test peut résoudre aussi bien
data.prod que data.prod.svc.cluster.local.
Enregistrements DNS
Quels objets reçoivent des enregistrements DNS ?
Les Services
Les Pods
Les sections suivantes décrivent en détail les types d'enregistrements DNS et la structure
pris en charge. Toute autre structure, tout autre nom ou toute autre requête qui se trouverait fonctionner
relève de détails d'implémentation susceptibles de changer sans préavis.
Pour une spécification plus à jour, consultez
Kubernetes DNS-Based Service Discovery.
Services
Enregistrements A/AAAA
Les Services « normaux » (non headless) reçoivent des enregistrements DNS A et/ou AAAA,
selon la ou les familles d'adresses IP du Service, avec un nom de la forme
my-svc.my-namespace.svc.cluster-domain.example. Ce nom est résolu en l'adresse IP de cluster
du Service.
Les Services headless
(sans IP de cluster) reçoivent eux aussi des enregistrements DNS A et/ou AAAA,
avec un nom de la forme my-svc.my-namespace.svc.cluster-domain.example. Contrairement aux Services
normaux, ce nom est résolu en l'ensemble des adresses IP de tous les Pods sélectionnés par le Service.
Les clients sont censés utiliser cet ensemble, ou bien y choisir une adresse
en round-robin standard.
Enregistrements SRV
Des enregistrements SRV sont créés pour les ports nommés des Services normaux ou
headless.
Pour chaque port nommé, l'enregistrement SRV a la forme
_port-name._port-protocol.my-svc.my-namespace.svc.cluster-domain.example.
Pour un Service normal, il est résolu en le numéro de port et le nom de domaine
my-svc.my-namespace.svc.cluster-domain.example.
Pour un Service headless, il est résolu en plusieurs réponses, une pour chaque Pod
sous-jacent au Service. Chaque réponse contient le numéro de port et le nom de domaine du Pod,
de la forme hostname.my-svc.my-namespace.svc.cluster-domain.example.
Pods
Enregistrements A/AAAA
Avant la mise en œuvre de la
spécification DNS,
les versions de Kube-DNS utilisaient la résolution DNS suivante :
Par exemple, si un Pod du namespace default a l'adresse IP 172.17.0.3,
et que le nom de domaine de votre cluster est cluster.local, le Pod a le nom DNS suivant :
172-17-0-3.default.pod.cluster.local
Certains mécanismes DNS de cluster, comme CoreDNS, fournissent aussi des enregistrements A de la forme :
Par exemple, si un Pod du namespace cafe a l'adresse IP 172.17.0.3,
qu'il est un point de terminaison d'un Service nommé barista et que le nom de domaine de votre cluster est
cluster.local, le Pod aura l'enregistrement DNS A suivant, propre au Service.
172-17-0-3.barista.cafe.svc.cluster.local
Champs hostname et subdomain d'un Pod
Actuellement, lorsqu'un Pod est créé, son nom d'hôte (vu depuis l'intérieur du Pod)
est la valeur metadata.name du Pod.
La spec du Pod a un champ facultatif hostname, qui permet d'indiquer un
autre nom d'hôte. Lorsqu'il est renseigné, il prime sur le nom du Pod pour
définir le nom d'hôte du Pod (toujours vu depuis l'intérieur du Pod). Par exemple,
un Pod dont spec.hostname vaut "my-host" aura pour
nom d'hôte "my-host".
La spec du Pod a aussi un champ facultatif subdomain, qui permet d'indiquer
que le Pod fait partie d'un sous-groupe du namespace. Par exemple, un Pod dont spec.hostname
vaut "foo" et spec.subdomain vaut "bar", dans le namespace "my-namespace", aura
pour nom d'hôte "foo" et pour nom de domaine pleinement qualifié (FQDN)
"foo.bar.my-namespace.svc.cluster.local" (là encore, vu depuis l'intérieur
du Pod).
S'il existe un Service headless dans le même namespace que le Pod, avec
le même nom que le sous-domaine, le serveur DNS du cluster renvoie aussi des enregistrements A et/ou AAAA
pour le nom d'hôte pleinement qualifié du Pod.
Exemple :
apiVersion:v1kind:Servicemetadata:name:busybox-subdomainspec:selector:name:busyboxclusterIP:Noneports:- name:foo# name is not required for single-port Servicesport:1234---apiVersion:v1kind:Podmetadata:name:busybox1labels:name:busyboxspec:hostname:busybox-1subdomain:busybox-subdomaincontainers:- image:busybox:1.28command:- sleep- "3600"name:busybox---apiVersion:v1kind:Podmetadata:name:busybox2labels:name:busyboxspec:hostname:busybox-2subdomain:busybox-subdomaincontainers:- image:busybox:1.28command:- sleep- "3600"name:busybox
Avec le Service "busybox-subdomain" ci-dessus et les Pods dont spec.subdomain
vaut "busybox-subdomain", le premier Pod verra
"busybox-1.busybox-subdomain.my-namespace.svc.cluster-domain.example" comme son propre FQDN. Le DNS fournit
des enregistrements A et/ou AAAA pour ce nom, qui pointent vers l'adresse IP du Pod. Les deux Pods « busybox1 » et
« busybox2 » auront chacun leurs propres enregistrements d'adresse.
Un EndpointSlice peut indiquer
le nom d'hôte DNS de n'importe quelle adresse de point de terminaison, avec son adresse IP.
Note:
Aucun enregistrement A ou AAAA n'est créé pour les noms de Pods si le Pod n'a pas de hostname.
Pour un Pod sans hostname mais avec un subdomain, seul
l'enregistrement A ou AAAA du Service headless (busybox-subdomain.my-namespace.svc.cluster-domain.example)
est créé ; il pointe vers les adresses IP des Pods. Par ailleurs, le Pod doit être prêt (ready) pour avoir un
enregistrement, sauf si publishNotReadyAddresses=True est défini sur le Service.
Champ setHostnameAsFQDN d'un Pod
Feature state:Stable since Kubernetes v1.22
Lorsqu'un Pod est configuré pour avoir un nom de domaine pleinement qualifié (FQDN), son
nom d'hôte est le nom d'hôte court. Par exemple, pour un Pod dont le nom de domaine
pleinement qualifié est busybox-1.busybox-subdomain.my-namespace.svc.cluster-domain.example,
la commande hostname exécutée dans ce Pod renvoie par défaut busybox-1, et la
commande hostname --fqdn renvoie le FQDN.
Lorsque vous définissez setHostnameAsFQDN: true dans la spec du Pod, le kubelet écrit le FQDN du Pod
comme nom d'hôte dans le namespace de ce Pod. Dans ce cas, hostname et hostname --fqdn
renvoient tous les deux le FQDN du Pod.
Note:
Sous Linux, le champ hostname du noyau (le champ nodename de struct utsname) est limité à 64 caractères.
Si un Pod active cette fonctionnalité et que son FQDN dépasse 64 caractères, il ne pourra pas démarrer.
Le Pod restera à l'état Pending (ContainerCreating dans kubectl) et générera
des événements d'erreur, comme Failed to construct FQDN from Pod hostname and cluster domain,
FQDN long-FQDN is too long (64 characters is the max, 70 characters requested).
Pour améliorer l'expérience utilisateur dans ce cas, vous pouvez créer un
contrôleur de webhook d'admission
qui vérifie la taille du FQDN lorsque les utilisateurs créent des objets de premier niveau, par exemple un Deployment.
Politique DNS d'un Pod
Les politiques DNS se définissent Pod par Pod. Actuellement, Kubernetes prend en charge
les politiques DNS suivantes pour les Pods. Elles sont indiquées dans le
champ dnsPolicy de la spec du Pod.
« Default » : le Pod hérite de la configuration de résolution de noms du nœud
sur lequel il s'exécute.
Consultez la discussion à ce sujet
pour plus de détails.
« ClusterFirst » : toute requête DNS qui ne correspond pas au suffixe de domaine configuré
pour le cluster, comme « www.kubernetes.io », est transmise par le serveur DNS à un serveur
de noms en amont. Les administrateurs du cluster peuvent avoir configuré des serveurs DNS supplémentaires,
pour des domaines de délégation (stub domains) ou en amont.
Consultez la discussion à ce sujet
pour savoir comment les requêtes DNS sont traitées dans ces cas.
« ClusterFirstWithHostNet » : pour les Pods qui s'exécutent avec hostNetwork, il faut
régler explicitement leur politique DNS sur « ClusterFirstWithHostNet ». Sinon, les Pods
qui s'exécutent avec hostNetwork et "ClusterFirst" se comporteront comme
avec la politique "Default".
Note:
Ce n'est pas pris en charge sous Windows. Pour plus de détails, voir ci-dessous.
« None » : permet à un Pod d'ignorer les paramètres DNS de l'environnement
Kubernetes. Tous les paramètres DNS sont alors censés être fournis par le
champ dnsConfig de la spec du Pod.
Consultez la sous-section Configuration DNS d'un Pod ci-dessous.
Note:
« Default » n'est pas la politique DNS par défaut. Si dnsPolicy n'est pas
indiqué explicitement, c'est « ClusterFirst » qui est utilisé.
L'exemple ci-dessous montre un Pod dont la politique DNS est
« ClusterFirstWithHostNet », car son champ hostNetwork vaut true.
La configuration DNS d'un Pod donne aux utilisateurs plus de contrôle sur les paramètres DNS de ce Pod.
Le champ dnsConfig est facultatif et fonctionne avec n'importe quelle valeur de dnsPolicy.
En revanche, lorsque le dnsPolicy d'un Pod vaut « None », le champ dnsConfig doit
être renseigné.
Voici les propriétés qu'un utilisateur peut indiquer dans le champ dnsConfig :
nameservers : une liste d'adresses IP qui serviront de serveurs DNS au
Pod. On peut indiquer au maximum 3 adresses IP. Lorsque le dnsPolicy du Pod
vaut « None », la liste doit contenir au moins une adresse IP ; dans les autres cas,
cette propriété est facultative.
Les serveurs indiqués sont ajoutés aux serveurs de noms de base générés à partir de la
politique DNS choisie, les adresses en double étant supprimées.
searches : une liste de domaines de recherche DNS pour la résolution des noms d'hôte dans le Pod.
Cette propriété est facultative. Si elle est renseignée, la liste fournie est fusionnée
avec les domaines de recherche de base générés à partir de la politique DNS choisie.
Les noms de domaine en double sont supprimés.
Kubernetes accepte jusqu'à 32 domaines de recherche.
options : une liste facultative d'objets, dont chacun peut avoir une propriété name
(obligatoire) et une propriété value (facultative). Le contenu de cette
propriété est fusionné avec les options générées à partir de la politique DNS choisie.
Les entrées en double sont supprimées.
Voici un exemple de Pod avec des paramètres DNS personnalisés :
apiVersion:v1kind:Podmetadata:namespace:defaultname:dns-examplespec:containers:- name:testimage:nginxdnsPolicy:"None"dnsConfig:nameservers:- 192.0.2.1# this is an examplesearches:- ns1.svc.cluster-domain.example- my.dns.search.suffixoptions:- name:ndotsvalue:"2"- name:edns0
Une fois le Pod ci-dessus créé, le fichier /etc/resolv.conf du conteneur test
a le contenu suivant :
Kubernetes lui-même ne limite la configuration DNS que lorsque la liste des domaines de recherche
dépasse 32 éléments, ou que la longueur totale de tous les domaines de recherche dépasse 2048.
Cette limite s'applique respectivement au fichier de configuration du résolveur du nœud, à la configuration DNS
du Pod et à la configuration DNS fusionnée.
Note:
Les anciennes versions de certains environnements d'exécution de conteneurs peuvent imposer leurs propres restrictions
sur le nombre de domaines de recherche DNS. Selon l'environnement d'exécution
de conteneurs, les Pods qui ont beaucoup de domaines de recherche DNS peuvent rester bloqués
à l'état Pending.
Ce problème est connu pour containerd v1.5.5 et versions antérieures, ainsi que pour
CRI-O v1.21 et versions antérieures.
Résolution DNS sur les nœuds Windows
ClusterFirstWithHostNet n'est pas pris en charge pour les Pods qui s'exécutent sur des nœuds Windows.
Windows considère tout nom qui contient un . comme un FQDN et ne fait pas de résolution FQDN.
Sous Windows, plusieurs résolveurs DNS peuvent être utilisés. Comme leurs
comportements diffèrent légèrement, il est recommandé d'utiliser la
cmdlet PowerShell Resolve-DNSName
pour résoudre les noms.
Sous Linux, vous disposez d'une liste de suffixes DNS, utilisée lorsque la résolution d'un nom
en tant que nom pleinement qualifié a échoué.
Sous Windows, vous ne pouvez avoir qu'un seul suffixe DNS : celui associé au
namespace du Pod (par exemple mydns.svc.cluster.local). Windows peut résoudre les FQDN, les Services
ou les noms réseau résolubles avec ce seul suffixe. Par exemple, un Pod lancé
dans le namespace default aura le suffixe DNS default.svc.cluster.local.
Dans un Pod Windows, vous pouvez résoudre à la fois kubernetes.default.svc.cluster.local
et kubernetes, mais pas les noms partiellement qualifiés (kubernetes.default ou
kubernetes.default.svc).
Kubernetes vous permet de configurer un réseau en pile simple IPv4, un réseau en pile simple IPv6, ou un réseau en double pile avec les deux familles d'adresses actives. Cette page explique comment.
Feature state:Stable since Kubernetes v1.23
Le réseau en double pile IPv4/IPv6 permet d'attribuer à la fois des adresses IPv4 et IPv6 aux
Pods et aux Services.
Le réseau en double pile IPv4/IPv6 est activé par défaut dans votre cluster Kubernetes depuis
la version 1.21, ce qui permet d'attribuer simultanément des adresses IPv4 et IPv6.
Fonctionnalités prises en charge
La double pile IPv4/IPv6 de votre cluster Kubernetes apporte les fonctionnalités suivantes :
Réseau des Pods en double pile (une adresse IPv4 et une adresse IPv6 attribuées à chaque Pod)
Services compatibles IPv4 et IPv6
Routage du trafic sortant des Pods vers l'extérieur du cluster (par exemple Internet) par des interfaces IPv4 et IPv6
Prérequis
Pour utiliser des clusters Kubernetes en double pile IPv4/IPv6, il vous faut :
Kubernetes 1.20 ou une version ultérieure
Pour savoir comment utiliser les Services en double pile avec des versions
antérieures de Kubernetes, consultez la documentation de la version
de Kubernetes concernée.
La prise en charge du réseau en double pile par le fournisseur (le fournisseur de cloud ou un autre
fournisseur doit pouvoir doter les nœuds Kubernetes d'interfaces réseau IPv4/IPv6 routables)
Un plugin réseau qui
prend en charge le réseau en double pile.
Configurer la double pile IPv4/IPv6
Pour configurer la double pile IPv4/IPv6, définissez des plages réseau en double pile pour le cluster :
--node-cidr-mask-size-ipv4|--node-cidr-mask-size-ipv6 vaut par défaut /24 pour IPv4 et /64 pour IPv6
kube-proxy :
--cluster-cidr=<IPv4 CIDR>,<IPv6 CIDR>
kubelet :
--node-ip=<IPv4 IP>,<IPv6 IP>
Cette option est obligatoire pour les nœuds bare metal en double pile (les nœuds qui ne définissent pas
de fournisseur de cloud avec l'option --cloud-provider). Si vous utilisez un fournisseur de cloud
et que vous choisissez de remplacer les adresses IP de nœud choisies par ce fournisseur, renseignez
l'option --node-ip.
(Les fournisseurs de cloud intégrés historiques ne prennent pas en charge --node-ip en double pile.)
Note:
Exemple de CIDR IPv4 : 10.244.0.0/16 (à remplacer par votre propre plage d'adresses)
Exemple de CIDR IPv6 : fdXY:IJKL:MNOP:15::/64 (cet exemple montre le format, mais ce n'est pas une
adresse valide ; voir la RFC 4193)
Services
Vous pouvez créer des Services qui utilisent IPv4, IPv6 ou les deux.
Par défaut, la famille d'adresses d'un Service est celle de la première plage d'adresses IP
des Services (configurée par l'option --service-cluster-ip-range de kube-apiserver).
Lorsque vous définissez un Service, vous pouvez le configurer en double pile si vous le souhaitez. Pour indiquer le comportement voulu,
donnez au champ .spec.ipFamilyPolicy l'une des valeurs suivantes :
SingleStack : Service en pile simple. Le plan de contrôle attribue une adresse IP de cluster au Service,
en utilisant la première plage d'adresses IP des Services configurée.
PreferDualStack : attribue au Service des adresses IP de cluster IPv4 et IPv6 si la double pile est activée. Si la double pile n'est pas activée ou pas prise en charge, le Service se comporte comme en pile simple.
RequireDualStack : attribue les .spec.clusterIPs du Service à partir des plages d'adresses IPv4 et IPv6 si la double pile est activée. Si la double pile n'est pas activée ou pas prise en charge, la création de l'objet Service dans l'API échoue.
Choisit .spec.clusterIP dans la liste .spec.clusterIPs en fonction de la famille d'adresses
du premier élément du tableau .spec.ipFamilies.
Si vous voulez choisir la famille d'adresses IP à utiliser en pile simple, ou l'ordre des familles
d'adresses IP en double pile, vous pouvez indiquer les familles d'adresses dans le champ facultatif
.spec.ipFamilies du Service.
Note:
Le champ .spec.ipFamilies n'est modifiable que sous certaines conditions : vous pouvez ajouter ou supprimer une famille
d'adresses IP secondaire, mais vous ne pouvez pas changer la famille d'adresses IP principale d'un Service existant.
Vous pouvez donner à .spec.ipFamilies l'une des valeurs de tableau suivantes :
["IPv4"]
["IPv6"]
["IPv4","IPv6"] (double pile)
["IPv6","IPv4"] (double pile)
La première famille de la liste est utilisée pour le champ historique .spec.clusterIP.
Scénarios de configuration des Services en double pile
Les exemples suivants montrent le comportement de différents scénarios de configuration de Services en double pile.
Options de double pile pour les nouveaux Services
Cette spécification de Service ne définit pas explicitement .spec.ipFamilyPolicy. Lorsque vous créez
ce Service, Kubernetes lui attribue une adresse IP de cluster prise dans la première plage
service-cluster-ip-range configurée, et renseigne SingleStack dans .spec.ipFamilyPolicy. (Les Services
sans sélecteurs et les
Services headless avec sélecteurs
se comportent de la même façon.)
Cette spécification de Service définit explicitement PreferDualStack dans .spec.ipFamilyPolicy. Lorsque
vous créez ce Service sur un cluster en double pile, Kubernetes lui attribue à la fois une adresse IPv4
et une adresse IPv6. Le plan de contrôle met à jour la .spec du Service pour enregistrer les adresses IP
attribuées. Le champ .spec.clusterIPs est le champ principal et contient les deux adresses IP
attribuées ; .spec.clusterIP est un champ secondaire dont la valeur est calculée à partir de
.spec.clusterIPs.
Pour le champ .spec.clusterIP, le plan de contrôle enregistre l'adresse IP qui appartient à
la même famille d'adresses que la première plage d'adresses IP des Services.
Sur un cluster en pile simple, les champs .spec.clusterIPs et .spec.clusterIP ne contiennent
tous les deux qu'une seule adresse.
Sur un cluster où la double pile est activée, indiquer RequireDualStack dans .spec.ipFamilyPolicy
a le même effet que PreferDualStack.
Cette spécification de Service définit explicitement IPv6 et IPv4 dans .spec.ipFamilies, ainsi
que PreferDualStack dans .spec.ipFamilyPolicy. Lorsque Kubernetes attribue une adresse IPv6 et
une adresse IPv4 dans .spec.clusterIPs, .spec.clusterIP reçoit l'adresse IPv6,
premier élément du tableau .spec.clusterIPs, ce qui remplace le comportement par défaut.
Valeurs par défaut de la double pile pour les Services existants
Les exemples suivants montrent le comportement par défaut lorsque la double pile est activée sur un cluster
où des Services existent déjà. (La mise à niveau d'un cluster existant vers la version 1.21 ou ultérieure
active la double pile.)
Lorsque la double pile est activée sur un cluster, le plan de contrôle configure les Services existants
(qu'ils soient IPv4 ou IPv6) en donnant à .spec.ipFamilyPolicy la valeur SingleStack et
à .spec.ipFamilies la famille d'adresses du Service existant. L'adresse IP de cluster du Service existant
est enregistrée dans .spec.clusterIPs.
Lorsque la double pile est activée sur un cluster, le plan de contrôle configure les
Services headless existants avec sélecteurs
en donnant à .spec.ipFamilyPolicy la valeur SingleStack et à .spec.ipFamilies la famille d'adresses
de la première plage d'adresses IP des Services (configurée par l'option
--service-cluster-ip-range de kube-apiserver), même si .spec.clusterIP vaut
None.
Passer un Service de la pile simple à la double pile, et inversement
Un Service peut passer de la pile simple à la double pile, et de la double pile à la pile simple.
Pour passer un Service de la pile simple à la double pile, faites passer .spec.ipFamilyPolicy de
SingleStack à PreferDualStack ou RequireDualStack, selon vos besoins. Lorsque vous passez ce
Service en double pile, Kubernetes lui attribue la famille d'adresses manquante, si bien que le
Service a désormais des adresses IPv4 et IPv6.
Modifiez la spécification du Service en passant .spec.ipFamilyPolicy de SingleStack à PreferDualStack.
Avant :
spec:ipFamilyPolicy:SingleStack
Après :
spec:ipFamilyPolicy:PreferDualStack
Pour passer un Service de la double pile à la pile simple, faites passer .spec.ipFamilyPolicy de
PreferDualStack ou RequireDualStack à SingleStack. Lorsque vous passez ce Service en
pile simple, Kubernetes ne conserve que le premier élément du tableau .spec.clusterIPs,
affecte cette adresse IP à .spec.clusterIP et donne à .spec.ipFamilies la famille
d'adresses de .spec.clusterIPs.
Services headless sans sélecteur
Pour les Services headless sans sélecteurs
dont .spec.ipFamilyPolicy n'est pas défini explicitement, le champ .spec.ipFamilyPolicy vaut par défaut
RequireDualStack.
Service de type LoadBalancer
Pour provisionner un équilibreur de charge en double pile pour votre Service :
Donnez au champ .spec.type la valeur LoadBalancer
Donnez au champ .spec.ipFamilyPolicy la valeur PreferDualStack ou RequireDualStack
Note:
Pour utiliser un Service de type LoadBalancer en double pile, votre fournisseur de cloud doit prendre en charge
les équilibreurs de charge IPv4 et IPv6.
Trafic sortant
Si vous voulez autoriser le trafic sortant pour joindre des destinations extérieures au cluster (par exemple
Internet) depuis un Pod qui utilise des adresses IPv6 non routables publiquement, vous devez permettre au Pod
d'utiliser une adresse IPv6 routée publiquement, grâce à un mécanisme comme un proxy transparent ou le
masquage d'adresses IP (IP masquerading). Le projet ip-masq-agent
prend en charge le masquage d'adresses IP sur les clusters en double pile.
Note:
Vérifiez que votre fournisseur CNI prend en charge IPv6.
Prise en charge de Windows
Kubernetes sous Windows ne prend pas en charge le réseau en pile simple « IPv6 uniquement ». En revanche,
le réseau en double pile IPv4/IPv6 est pris en charge pour les Pods et les nœuds, avec des Services
d'une seule famille d'adresses.
Vous pouvez utiliser le réseau en double pile IPv4/IPv6 avec les réseaux l2bridge.
Note:
Sous Windows, les réseaux overlay (VXLAN) ne prennent pas en charge le réseau en double pile.
Pour en savoir plus sur les différents modes réseau de Windows, consultez la page
Réseau sous Windows.
Le routage tenant compte de la topologie (Topology Aware Routing) fournit un mécanisme qui aide à garder le trafic réseau dans sa zone d'origine. Privilégier le trafic dans la même zone entre les Pods de votre cluster peut améliorer la fiabilité, les performances (latence et débit réseau) ou réduire les coûts.
Feature state:Beta since Kubernetes v1.23
Note:
Avant Kubernetes 1.27, cette fonctionnalité s'appelait Topology Aware Hints.
Le routage tenant compte de la topologie adapte le comportement du routage pour
garder de préférence le trafic dans sa zone d'origine. Dans certains cas,
cela peut réduire les coûts ou améliorer les performances réseau.
Motivation
Les clusters Kubernetes sont de plus en plus souvent déployés dans des
environnements multizones. Le routage tenant compte de la topologie fournit un
mécanisme qui aide à garder le trafic dans sa zone d'origine. Lorsqu'il
calcule les points de terminaison d'un Service, le contrôleur EndpointSlice tient compte
de la topologie (région et zone) de chaque point de terminaison et renseigne le
champ hints (indications) pour l'attribuer à une zone. Les composants du
cluster, comme kube-proxy, peuvent ensuite utiliser ces
indications pour orienter le routage du trafic (en privilégiant les points de
terminaison topologiquement les plus proches).
Activer le routage tenant compte de la topologie
Note:
Avant Kubernetes 1.27, ce comportement était contrôlé par l'annotation
service.kubernetes.io/topology-aware-hints.
Vous pouvez activer le routage tenant compte de la topologie pour un Service en
définissant l'annotation service.kubernetes.io/topology-mode sur Auto.
Lorsque chaque zone dispose de suffisamment de points de terminaison
disponibles, des indications de topologie sont ajoutées aux EndpointSlices pour attribuer chaque
point de terminaison à une zone précise. Le trafic est alors acheminé plus près
de son origine.
Quand cela fonctionne le mieux
Cette fonctionnalité donne les meilleurs résultats lorsque :
1. Le trafic entrant est réparti uniformément
Si une grande partie du trafic provient d'une seule zone, ce trafic risque de
surcharger le sous-ensemble de points de terminaison attribués à cette zone.
Cette fonctionnalité est déconseillée lorsque le trafic entrant est censé
provenir d'une seule zone.
2. Le Service a au moins 3 points de terminaison par zone
Dans un cluster à trois zones, cela représente au moins 9 points de terminaison.
Avec moins de 3 points de terminaison par zone, il y a une forte probabilité
(environ 50 %) que le contrôleur EndpointSlice ne parvienne pas à répartir les
points de terminaison de manière équilibrée et se rabatte sur le routage par
défaut à l'échelle du cluster.
Fonctionnement
L'heuristique « Auto » tente d'attribuer à chaque zone un nombre de points de
terminaison proportionnel. Cette heuristique donne de meilleurs résultats pour
les Services qui ont un nombre important de points de terminaison.
Contrôleur EndpointSlice
Le contrôleur EndpointSlice est chargé de définir les indications sur les
EndpointSlices lorsque cette heuristique est activée. Le contrôleur attribue à
chaque zone une part proportionnelle des points de terminaison. Cette proportion
dépend du nombre de cœurs CPU
allouables
des nœuds de cette zone. Par exemple, si une zone dispose de 2 cœurs CPU et
une autre d'un seul, le contrôleur attribuera deux fois plus de points de
terminaison à la zone qui dispose de 2 cœurs.
L'exemple suivant montre un EndpointSlice dont les indications ont été
renseignées :
Le composant kube-proxy filtre les points de terminaison vers lesquels il
achemine le trafic en fonction des indications définies par le contrôleur EndpointSlice. Dans
la plupart des cas, kube-proxy peut ainsi acheminer le trafic vers des points de
terminaison de la même zone. Il arrive que le contrôleur attribue des points de
terminaison d'une autre zone pour mieux équilibrer leur répartition entre les
zones. Une partie du trafic est alors acheminée vers d'autres zones.
Garde-fous
Le plan de contrôle de Kubernetes et le kube-proxy de chaque nœud appliquent
certains garde-fous avant d'utiliser les indications de topologie. Si
l'un d'eux n'est pas respecté, kube-proxy choisit des points de terminaison
n'importe où dans le cluster, quelle que soit la zone.
Nombre insuffisant de points de terminaison : s'il y a moins de points de
terminaison que de zones dans le cluster, le contrôleur n'attribue aucune
indication.
Répartition équilibrée impossible : dans certains cas, il est impossible
de répartir les points de terminaison de manière équilibrée entre les zones.
Par exemple, si la zone-a est deux fois plus grande que la zone-b mais qu'il
n'y a que 2 points de terminaison, celui attribué à la zone-a risque de
recevoir deux fois plus de trafic que celui de la zone-b. Le contrôleur
n'attribue pas d'indications s'il ne parvient pas à ramener cette valeur de
« surcharge estimée » sous un seuil acceptable pour chaque zone. À noter :
ce calcul ne repose pas sur des mesures en temps réel. Un point de
terminaison peut toujours se retrouver surchargé.
Informations insuffisantes sur un ou plusieurs nœuds : si un nœud n'a pas
de label topology.kubernetes.io/zone ou ne remonte pas de valeur de CPU
allouable, le plan de contrôle ne définit aucune indication de topologie sur
les points de terminaison, et kube-proxy ne filtre donc pas les points de
terminaison par zone.
Un ou plusieurs points de terminaison n'ont pas d'indication de zone :
kube-proxy considère alors qu'un passage aux indications de topologie, ou
leur abandon, est en cours. Filtrer les points de terminaison d'un Service
dans cet état serait risqué : kube-proxy se rabat donc sur tous les points de
terminaison.
Une zone n'apparaît dans aucune indication : si kube-proxy ne trouve
aucun point de terminaison dont l'indication désigne la zone dans laquelle il
s'exécute, il utilise les points de terminaison de toutes les zones. Cette
situation se produit surtout lorsque vous ajoutez une nouvelle zone à un
cluster existant.
Contraintes
Les indications de topologie ne sont pas utilisées lorsque internalTrafficPolicy
vaut Local sur un Service. Les deux fonctionnalités peuvent coexister dans un
même cluster sur des Services différents, mais pas sur le même Service.
Cette approche fonctionne mal pour les Services dont une grande partie du
trafic provient d'un sous-ensemble de zones. Elle suppose au contraire que le
trafic entrant est à peu près proportionnel à la capacité des nœuds de chaque
zone.
Le contrôleur EndpointSlice ignore les nœuds qui ne sont pas prêts lorsqu'il
calcule la part de chaque zone. Cela peut avoir des conséquences inattendues
si une grande partie des nœuds ne sont pas prêts.
Le contrôleur EndpointSlice ignore les nœuds qui portent le label
node-role.kubernetes.io/control-plane ou node-role.kubernetes.io/master.
Cela peut poser problème si des charges de travail s'exécutent aussi sur ces
nœuds.
Le contrôleur EndpointSlice ne tient pas compte des tolérances lors du déploiement ni lors du
calcul de la part de chaque zone. Si les Pods d'un Service sont limités à un
sous-ensemble des nœuds du cluster, cela n'est pas pris en compte.
Cela peut mal fonctionner avec la mise à l'échelle automatique. Par exemple,
si une grande partie du trafic provient d'une seule zone, seuls les points de terminaison attribués
à cette zone traiteront ce trafic. Il se peut alors que l'Horizontal Pod Autoscaler ne
détecte pas cette situation, ou que les nouveaux pods démarrent dans une autre
zone.
Heuristiques personnalisées
Kubernetes est déployé de bien des façons, et aucune heuristique unique
d'attribution des points de terminaison aux zones ne convient à tous les cas
d'usage. L'un des principaux objectifs de cette fonctionnalité est de permettre
le développement d'heuristiques personnalisées lorsque l'heuristique intégrée ne
convient pas à votre cas d'usage. Les premiers éléments permettant des
heuristiques personnalisées ont été intégrés dans la version 1.27. Il s'agit
d'une implémentation limitée, qui ne couvre peut-être pas encore certaines
situations pertinentes et plausibles.
Découvrir le champ
trafficDistribution,
étroitement lié à l'annotation service.kubernetes.io/topology-mode, qui offre
des options souples pour le routage du trafic dans Kubernetes.
10 - Réseau sous Windows
Kubernetes prend en charge les nœuds Linux comme les nœuds Windows, et vous pouvez mélanger
les deux dans un même cluster.
Cette page donne une vue d'ensemble des aspects réseau propres au système d'exploitation Windows.
Le réseau des conteneurs sous Windows
Le réseau des conteneurs Windows est fourni par des
plugins CNI.
Côté réseau, les conteneurs Windows se comportent comme des machines virtuelles.
Chaque conteneur a une carte réseau virtuelle (vNIC), reliée
à un commutateur virtuel Hyper-V (vSwitch). Le Host Networking Service (HNS) et le
Host Compute Service (HCS) collaborent pour créer les conteneurs et rattacher
leurs vNIC aux réseaux. HCS gère les conteneurs, tandis que HNS
gère les ressources réseau, comme :
les réseaux virtuels (y compris la création des vSwitch) ;
les points de terminaison (ou vNIC) ;
les namespaces ;
les politiques, notamment l'encapsulation des paquets, les règles d'équilibrage de charge, les ACL et les règles de NAT.
Le HNS et le vSwitch de Windows mettent en œuvre l'isolation par namespaces et peuvent
créer des cartes réseau virtuelles selon les besoins d'un pod ou d'un conteneur. En revanche, une grande partie
de la configuration, comme le DNS, les routes et les métriques, est stockée dans la base de registre Windows, et non
dans des fichiers sous /etc, comme c'est le cas sous Linux. La base de registre du conteneur
est distincte de celle de l'hôte : des pratiques comme monter le fichier /etc/resolv.conf de
l'hôte dans un conteneur n'ont donc pas le même effet que sous Linux. Ces réglages doivent
être faits avec les API Windows, exécutées dans le contexte du conteneur. C'est pourquoi
les implémentations CNI doivent appeler le HNS pour transmettre les informations réseau au pod ou au conteneur,
au lieu de s'appuyer sur des montages de fichiers.
Modes réseau
Windows prend en charge cinq pilotes (ou modes) réseau différents : L2bridge, L2tunnel,
Overlay (bêta), Transparent et NAT. Dans un cluster hétérogène comportant des nœuds de travail Windows et Linux,
vous devez choisir une solution réseau compatible avec
Windows et Linux. Le tableau suivant liste les plugins externes (out-of-tree) pris en charge sous Windows,
et indique quand utiliser chaque plugin CNI :
Pilote réseau
Description
Modifications des paquets des conteneurs
Plugins réseau
Caractéristiques des plugins réseau
L2bridge
Les conteneurs sont reliés à un vSwitch externe. Ils sont rattachés au réseau sous-jacent (underlay), mais le réseau physique n'a pas besoin de connaître leurs adresses MAC, car elles sont réécrites en entrée et en sortie.
L'adresse MAC est remplacée par celle de l'hôte ; l'adresse IP peut l'être aussi via la politique HNS OutboundNAT.
win-bridge utilise le mode réseau L2bridge et relie les conteneurs au réseau sous-jacent des hôtes, ce qui offre les meilleures performances. Nécessite des routes définies par l'utilisateur (UDR) pour la connectivité entre nœuds.
L2Tunnel
Cas particulier de l2bridge, utilisé uniquement sur Azure. Tous les paquets sont envoyés à l'hôte de virtualisation, où la politique SDN est appliquée.
L'adresse MAC est réécrite, l'adresse IP est visible sur le réseau sous-jacent.
Chaque conteneur reçoit une vNIC reliée à un vSwitch externe. Chaque réseau overlay a son propre sous-réseau IP, défini par un préfixe IP personnalisé. Le pilote réseau overlay utilise l'encapsulation VXLAN.
Les paquets sont encapsulés avec un en-tête externe.
win-overlay est à utiliser lorsque l'on souhaite isoler les réseaux virtuels des conteneurs du réseau sous-jacent des hôtes (par exemple pour des raisons de sécurité). Permet de réutiliser les mêmes adresses IP dans différents réseaux overlay (qui ont des étiquettes VNID différentes) si vous disposez de peu d'adresses IP dans votre datacenter. Cette option nécessite la mise à jour KB4489899 sur Windows Server 2019.
Transparent (cas d'usage particulier pour ovn-kubernetes)
Nécessite un vSwitch externe. Les conteneurs sont reliés à un vSwitch externe qui permet la communication intra-pod via des réseaux logiques (commutateurs et routeurs logiques).
Les paquets sont encapsulés dans un tunnel GENEVE ou STT pour joindre les pods qui ne sont pas sur le même hôte. Les paquets sont transmis ou rejetés selon les métadonnées de tunnel fournies par le contrôleur réseau OVN. Le NAT est appliqué pour la communication nord-sud.
Déploiement avec Ansible. Des ACL distribuées peuvent être appliquées via les politiques Kubernetes. Prise en charge de l'IPAM. L'équilibrage de charge est possible sans kube-proxy. Le NAT se fait sans iptables ni netsh.
NAT (non utilisé dans Kubernetes)
Chaque conteneur reçoit une vNIC reliée à un vSwitch interne. Le DNS et le DHCP sont fournis par un composant interne appelé WinNAT.
Les adresses MAC et IP sont remplacées par celles de l'hôte.
Ce plugin peut déléguer à l'un des plugins CNI de référence (win-overlay,
win-bridge) afin de fonctionner avec le démon Flannel sous Windows (Flanneld), qui
attribue automatiquement un bail de sous-réseau à chaque nœud et crée le réseau HNS. Le plugin lit
son propre fichier de configuration (cni.conf) et le complète avec les variables
d'environnement du fichier subnet.env généré par FlannelD. Il confie ensuite la mise en place
du réseau à l'un des plugins CNI de référence, et transmet au plugin IPAM (par exemple host-local)
la configuration adéquate, qui contient le sous-réseau attribué au nœud.
Pour les objets Node, Pod et Service, les flux réseau suivants sont pris en charge pour
le trafic TCP/UDP :
Pod → Pod (IP)
Pod → Pod (nom)
Pod → Service (adresse IP de cluster)
Pod → Service (PQDN, uniquement s'il ne contient pas de « . »)
Pod → Service (FQDN)
Pod → externe (IP)
Pod → externe (DNS)
Nœud → Pod
Pod → Nœud
Gestion des adresses IP (IPAM)
Les options d'IPAM suivantes sont prises en charge sous Windows :
This is a stable feature in Kubernetes, and has been since version v1.34. It was first available in the v1.14 release. You can no longer disable or opt out of this feature or behavior (it is locked); if you explicitly set a value for the associated feature gate WinDSR, Kubernetes ignores it but does not report any error.
Mode d'équilibrage de charge dans lequel la correction des adresses IP et le LBNAT se font directement sur le port vSwitch du conteneur :
le trafic du Service arrive avec l'adresse IP du pod d'origine comme adresse source.
Cela améliore les performances : les réponses, qui repasseraient normalement par l'équilibreur de charge,
peuvent le contourner et aller directement au client.
La charge de l'équilibreur diminue, et la latence globale aussi.
Pour en savoir plus, lisez
Direct Server Return (DSR) in a nutshell.
Équilibrage de charge et Services
Un Service Kubernetes est une abstraction
qui définit un ensemble logique de Pods et un moyen d'y accéder sur le réseau.
Dans un cluster qui comprend des nœuds Windows, vous pouvez utiliser les types de Service suivants :
Ajoutez l'argument de ligne de commande suivant (pour la version 1.37) : --enable-dsr=true
Preserve-Destination
N'applique pas de DNAT au trafic du Service, ce qui préserve l'adresse IP virtuelle du Service cible dans les paquets qui arrivent au Pod backend. Désactive aussi le transfert entre nœuds.
Windows Server, version 1903
Ajoutez "preserve-destination": "true" dans les annotations du Service et activez DSR dans kube-proxy.
Réseau en double pile IPv4/IPv6
Communications natives IPv4 vers IPv4, en parallèle des communications IPv6 vers IPv6, vers le cluster, depuis le cluster et au sein du cluster
Garantit que l'adresse IP source du trafic entrant est préservée. Désactive aussi le transfert entre nœuds.
Windows Server 2019
Donnez à service.spec.externalTrafficPolicy la valeur Local et activez DSR dans kube-proxy
Limites
Les fonctionnalités réseau suivantes ne sont pas prises en charge sur les nœuds Windows :
le mode réseau de l'hôte (host networking) ;
l'accès local à un NodePort depuis le nœud lui-même (cela fonctionne depuis d'autres nœuds ou des clients externes) ;
plus de 64 pods backend (ou adresses de destination distinctes) pour un même Service ;
la communication IPv6 entre pods Windows connectés à des réseaux overlay ;
la politique de trafic Local hors mode DSR ;
les communications sortantes en ICMP via les plugins win-overlay ou win-bridge, ou via le plugin Azure-CNI.
Plus précisément, le plan de données de Windows (VFP)
ne prend pas en charge la transposition des paquets ICMP. Concrètement :
les paquets ICMP destinés au même réseau (par exemple un ping d'un pod à un autre)
fonctionnent normalement ;
les paquets TCP/UDP fonctionnent normalement ;
les paquets ICMP qui doivent traverser un réseau distant (par exemple un ping d'un pod vers Internet)
ne peuvent pas être transposés : ils ne sont donc pas réacheminés vers leur source ;
comme les paquets TCP/UDP peuvent, eux, être transposés, vous pouvez remplacer ping <destination> par
curl <destination> pour diagnostiquer la connectivité avec l'extérieur.
Autres limites :
Les plugins réseau de référence de Windows, win-bridge et win-overlay, ne mettent pas en œuvre
la spécification CNI v0.4.0,
car l'opération CHECK n'y est pas implémentée.
Le plugin CNI Flannel VXLAN a les limites suivantes sous Windows :
La connectivité nœud-pod n'est possible qu'avec les pods locaux, à partir de Flannel v0.12.0.
Flannel est limité au VNI 4096 et au port UDP 4789. Consultez la documentation officielle
du backend Flannel VXLAN
pour plus de détails sur ces paramètres.
11 - Allocation des ClusterIP des Services
Dans Kubernetes, les Services sont un moyen abstrait
d'exposer une application qui s'exécute sur un ensemble de Pods. Les Services
peuvent disposer d'une adresse IP virtuelle à l'échelle du cluster (avec un Service de type: ClusterIP).
Les clients peuvent se connecter à cette adresse IP virtuelle, et Kubernetes répartit alors
le trafic destiné à ce Service entre les différents Pods sous-jacents.
Comment les ClusterIP des Services sont-elles allouées ?
Lorsque Kubernetes doit attribuer une adresse IP virtuelle à un Service,
cette attribution se fait de l'une des deux manières suivantes :
dynamiquement
le plan de contrôle du cluster choisit automatiquement une adresse IP libre dans la plage configurée pour les Services de type: ClusterIP.
statiquement
vous indiquez l'adresse IP de votre choix, dans la plage configurée pour les Services.
Dans tout le cluster, chaque ClusterIP de Service doit être unique.
Tenter de créer un Service avec une ClusterIP précise qui a déjà
été allouée renvoie une erreur.
Pourquoi réserver des ClusterIP des Services ?
Il peut arriver que vous souhaitiez que des Services soient joignables à des adresses IP bien connues, afin que
d'autres composants et utilisateurs du cluster puissent les utiliser.
Le meilleur exemple est le Service DNS du cluster. Par convention informelle, certains outils d'installation de Kubernetes attribuent la 10e adresse IP
de la plage des Services au Service DNS. Si vous avez configuré votre cluster avec la plage d'adresses IP des Services
10.96.0.0/16 et que vous voulez que l'adresse IP de votre Service DNS soit 10.96.0.10, il vous faudrait créer un Service comme
celui-ci :
Mais, comme expliqué précédemment, l'adresse IP 10.96.0.10 n'a pas été réservée.
Si d'autres Services sont créés avec une allocation dynamique avant lui ou en même temps que lui, l'un d'eux risque de se voir attribuer cette adresse IP.
Vous ne pourrez alors pas créer le Service DNS, car sa création échouera avec une erreur de conflit.
Comment éviter les conflits de ClusterIP des Services ?
La stratégie d'allocation mise en œuvre dans Kubernetes pour attribuer des ClusterIP aux Services réduit le
risque de collision.
La plage de ClusterIP est divisée selon la formule min(max(16, cidrSize / 16), 256),
que l'on peut décrire ainsi : jamais moins de 16 ni plus de 256, avec une progression graduelle entre les deux.
L'attribution dynamique d'adresses IP puise par défaut dans la bande supérieure ; une fois celle-ci épuisée, elle
puise dans la bande inférieure. Les utilisateurs peuvent ainsi recourir à des allocations statiques dans la bande inférieure avec un faible
risque de collision.
Exemples
Exemple 1
Cet exemple utilise la plage d'adresses IP 10.96.0.0/24 (notation CIDR) pour les adresses IP
des Services.
Taille de la plage : 28 - 2 = 254 Décalage de la bande : min(max(16, 256/16), 256) = min(16, 256) = 16 Début de la bande statique : 10.96.0.1 Fin de la bande statique : 10.96.0.16 Fin de la plage : 10.96.0.254
pie showData
    title 10.96.0.0/24
    "Statique" : 16
    "Dynamique" : 238
Exemple 2
Cet exemple utilise la plage d'adresses IP 10.96.0.0/20 (notation CIDR) pour les adresses IP
des Services.
Taille de la plage : 212 - 2 = 4094 Décalage de la bande : min(max(16, 4096/16), 256) = min(256, 256) = 256 Début de la bande statique : 10.96.0.1 Fin de la bande statique : 10.96.1.0 Fin de la plage : 10.96.15.254
pie showData
    title 10.96.0.0/20
    "Statique" : 256
    "Dynamique" : 3838
Exemple 3
Cet exemple utilise la plage d'adresses IP 10.96.0.0/16 (notation CIDR) pour les adresses IP
des Services.
Taille de la plage : 216 - 2 = 65534 Décalage de la bande : min(max(16, 65536/16), 256) = min(4096, 256) = 256 Début de la bande statique : 10.96.0.1 Fin de la bande statique : 10.96.1.0 Fin de la plage : 10.96.255.254
pie showData
    title 10.96.0.0/16
    "Statique" : 256
    "Dynamique" : 65278
Si deux Pods de votre cluster veulent communiquer et qu'ils s'exécutent effectivement tous les deux sur le même nœud, utilisez la politique de trafic interne des Services pour que le trafic réseau reste sur ce nœud. Éviter un aller-retour par le réseau du cluster peut contribuer à la fiabilité, aux performances (latence et débit réseau) ou à la réduction des coûts.
Feature state:Stable since Kubernetes v1.26
La politique de trafic interne des Services (Service Internal Traffic Policy)
permet de restreindre le trafic interne afin qu'il ne soit acheminé que vers les
points de terminaison situés sur le nœud d'où provient ce trafic. Le trafic
« interne » désigne ici le trafic émis par les Pods du cluster courant. Cela peut
aider à réduire les coûts et à améliorer les performances.
Utiliser la politique de trafic interne des Services
Vous pouvez activer la politique de trafic « interne uniquement » pour un
Service en définissant son champ
.spec.internalTrafficPolicy sur Local. Cela indique à kube-proxy de n'utiliser
que les points de terminaison locaux au nœud pour le trafic interne au cluster.
Note:
Pour les Pods situés sur des nœuds qui n'ont aucun point de terminaison pour un
Service donné, le Service se comporte comme s'il n'avait aucun point de terminaison
(pour les Pods de ce nœud), même s'il en possède bel et bien sur d'autres nœuds.
L'exemple suivant montre un Service dont le champ
.spec.internalTrafficPolicy est défini sur Local :
kube-proxy filtre les points de terminaison vers lesquels il achemine le trafic en
fonction du paramètre spec.internalTrafficPolicy. Lorsqu'il vaut Local, seuls
les points de terminaison locaux au nœud sont pris en compte. Lorsqu'il vaut
Cluster (la valeur par défaut) ou qu'il n'est pas défini, Kubernetes prend en
compte tous les points de terminaison.